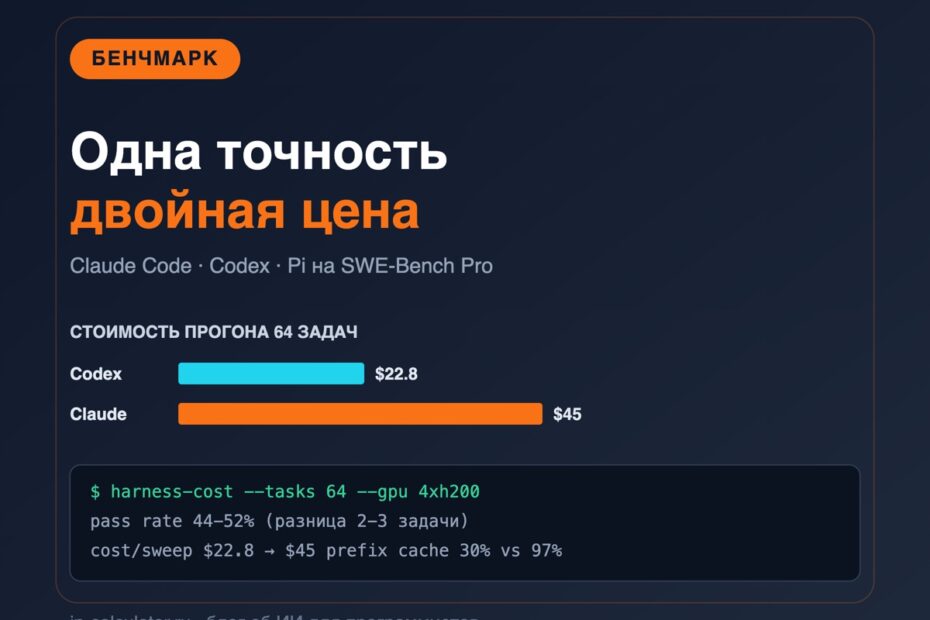
В сентябре 2026 года вышли два независимых замера, которые ломают привычный вопрос «какой агент лучше». Команда aistack из imec прогнала 64 задачи из SWE-Bench Pro через Claude Code, Codex и Pi и получила разброс по доле решённых задач всего в 2–3 задачи — при том что стоимость одного прогона на одинаковом железе отличалась почти вдвое: $22,8 у Codex против $45 у Claude Code и Pi (aistack, 10.09.2026). Через неделю Runta опубликовала свой лидерборд FrontierHarness: 9 обвязок, 30 задач, 360 прогонов — там разброс pass rate составил всего 17 пунктов, а стоимость одной решённой задачи отличалась в 17 раз (runta). Ниже — что именно измеряли, какие цифры получились и почему «выбирать модель» в 2026-м — неполный вопрос.
Что такое harness и почему он попал в замер
Harness (обвязка) — это то, что вы реально ставите и запускаете: Claude Code, Codex, OpenCode, Pi. Модель «думает», а harness решает, о чём именно она думает, какие тулзы ей доступны, как собирается контекст и когда работа останавливается. Именно обвязка отвечает за system prompt, оркестрацию инструментов, форматирование промптов, парсинг вывода, восстановление после ошибок и условия остановки.
В imec для чистоты сравнения зафиксировали всё, кроме обвязки: две модели (Qwen3.8-27B в FP8 на одной NVIDIA H200 и GLM-5.3-Flash на четырёх H200), одинаковые настройки inference-движка, одинаковый набор из 64 задач, к которому вернулись из первой статьи. Harness’ы запускались со стандартными настройками, без кастомизации — «as-is». Такая постановка позволяет увидеть вклад обвязки, а не модели.
Результаты: точность сравнялась, счёт разошёлся
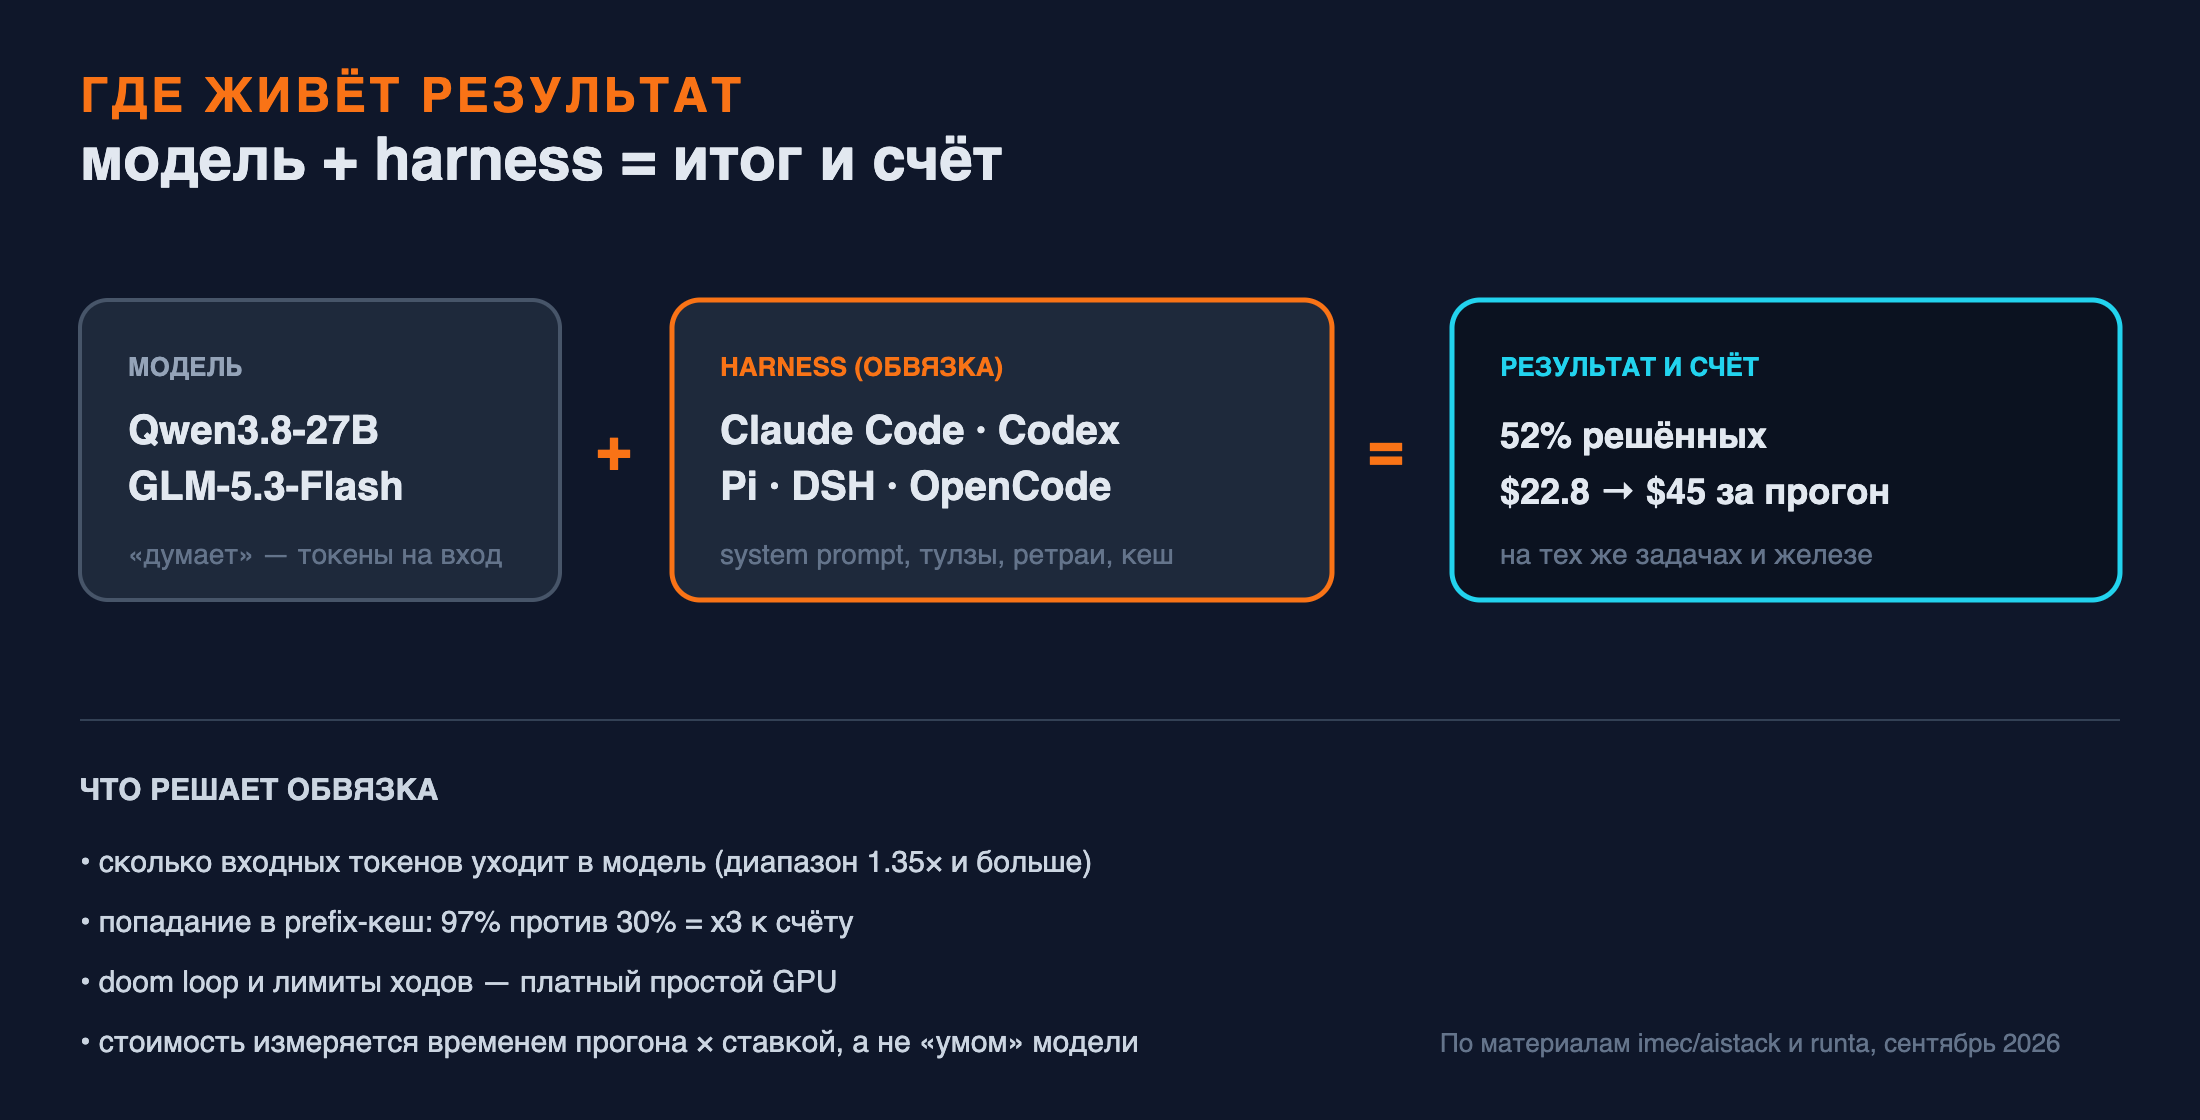
Главный вывод imec — доля решённых задач у трёх обвязок практически одинаковая:
| Harness | Qwen3.8-27B (1×H200) | GLM-5.3-Flash (4×H200) |
|---|---|---|
| Claude Code | 33/64 (52%) | 32/64 (50%) |
| Codex | 31/64 (48%) | 33/64 (52%) |
| Pi | 28/64 (44%) | 32/64 (50%) |
Разница между прогонами — 2–3 задачи, то есть на грани шума. А теперь стоимость того же 64-задачного прогона (время работы GPU, умноженное на ставку):
| Harness | Qwen (1×H200, $4,54/ч) | GLM (4×H200, $18,16/ч) |
|---|---|---|
| Codex | ~$9 | $22,8 |
| Claude Code | $10,26 | $45 |
| Pi | $10,16 | $45 |
На маленькой модели разница незаметна. На четырёх H200 та же точность обходится почти вдвое дороже — «просто потому, что вы сменили harness». Для сравнения: тот же объём работы по API-прайсу Anthropic стоил бы около $98.
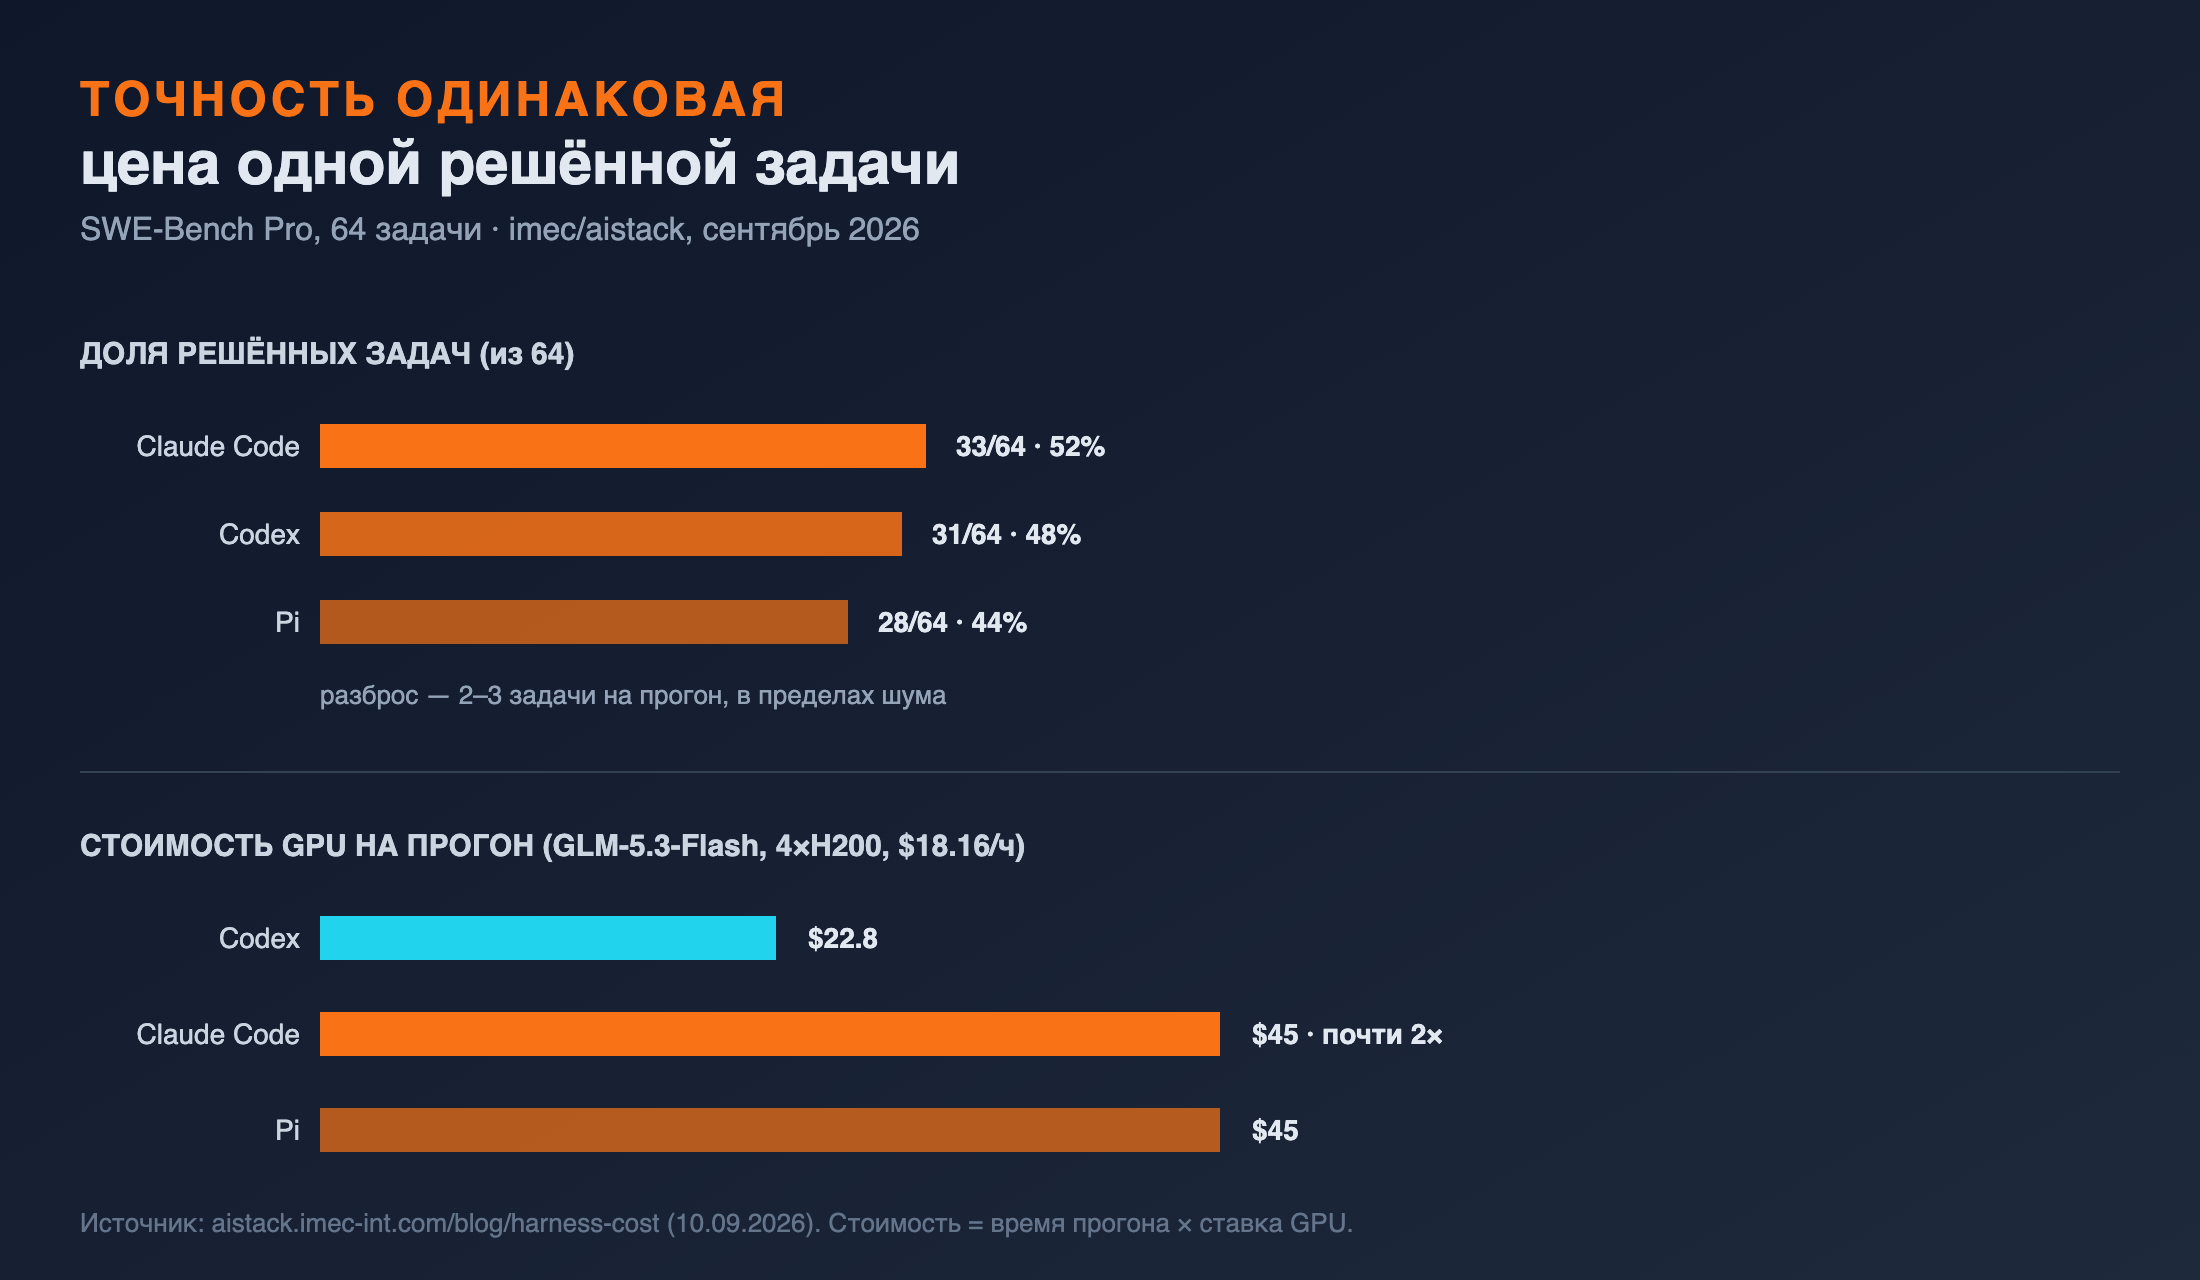
Откуда берётся разрыв — видно по токенам. На Qwen3.8-27B Claude Code прогоняет через модель около 445,8 млн входных токенов, а Codex — 330,5 млн: в 1,35 раза больше контекста ради одной дополнительной решённой задачи. На GLM-5.3-Flash разрыв ещё больше — 480,2 млн против 192,1 млн. Авторы формулируют это прямо: «больше контекста не значит больше решённых задач, это просто делает каждое решение дороже».
Второй замер: 17-кратный разброс цены за задачу
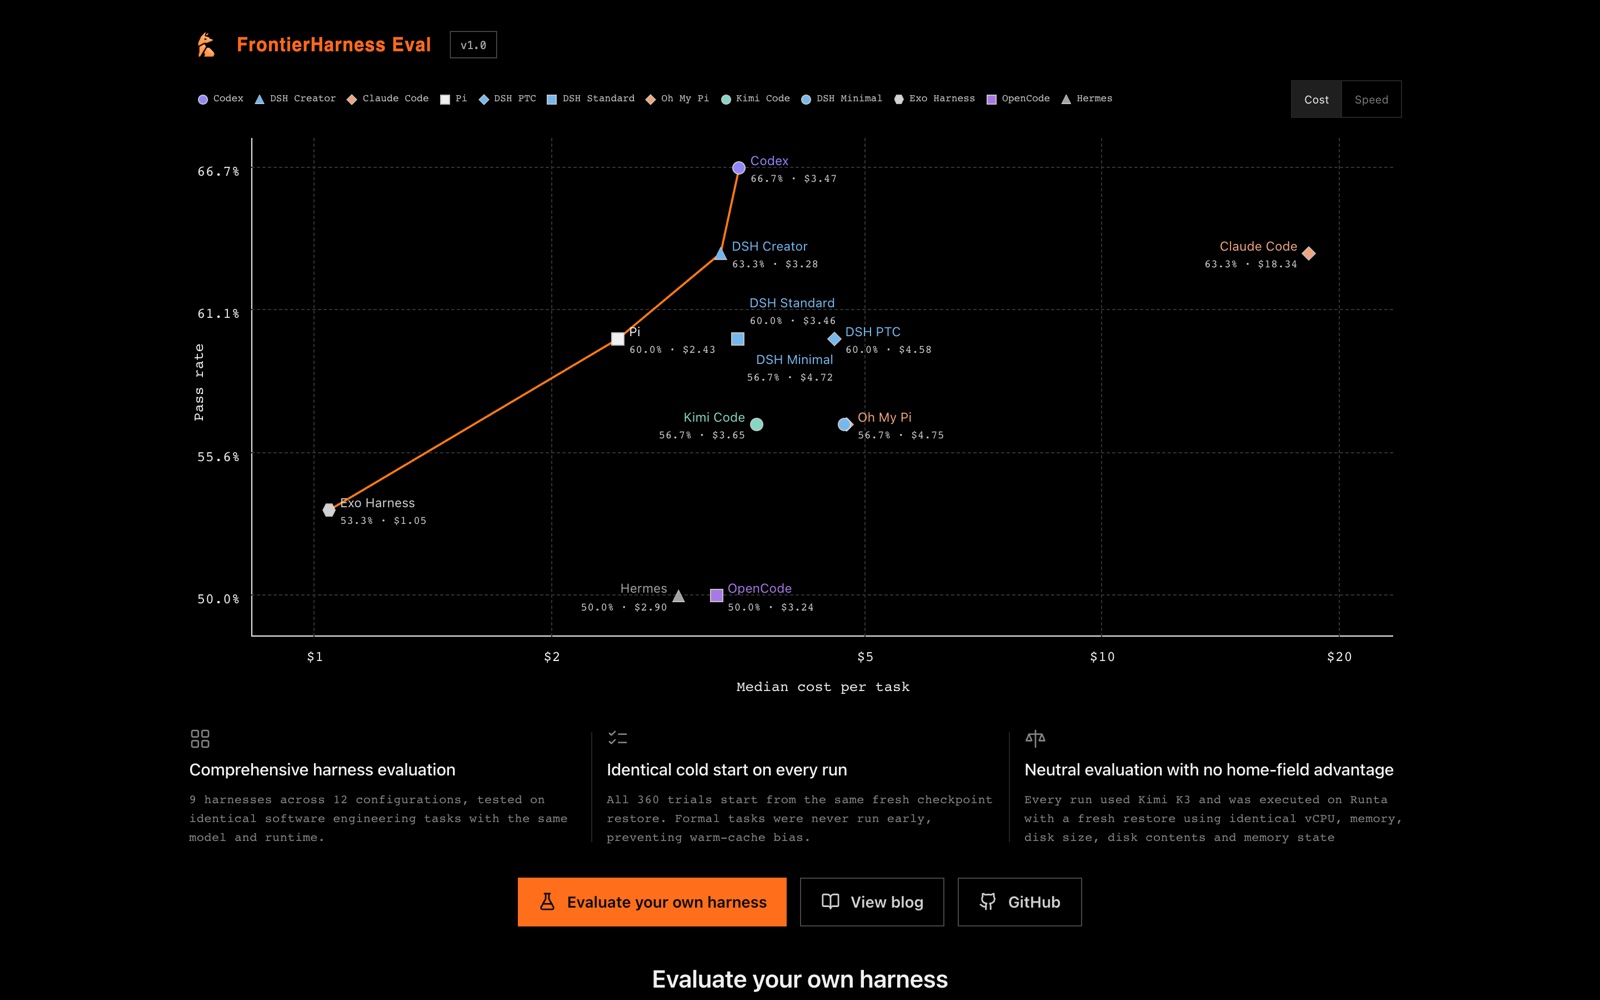
Лидерборд Runta FrontierHarness v1.0 покрывает 30 задач (21 из Terminal-Bench и 9 из DeepSWE), 9 harness’ов и 12 конфигураций — 360 прогонов. Все стартуют с одного чекпоинта (одинаковые vCPU, память, диск), модель у всех одна — Kimi K3, поданная через один и тот же шлюз, чтобы ни у кого не было «домашнего преимущества».
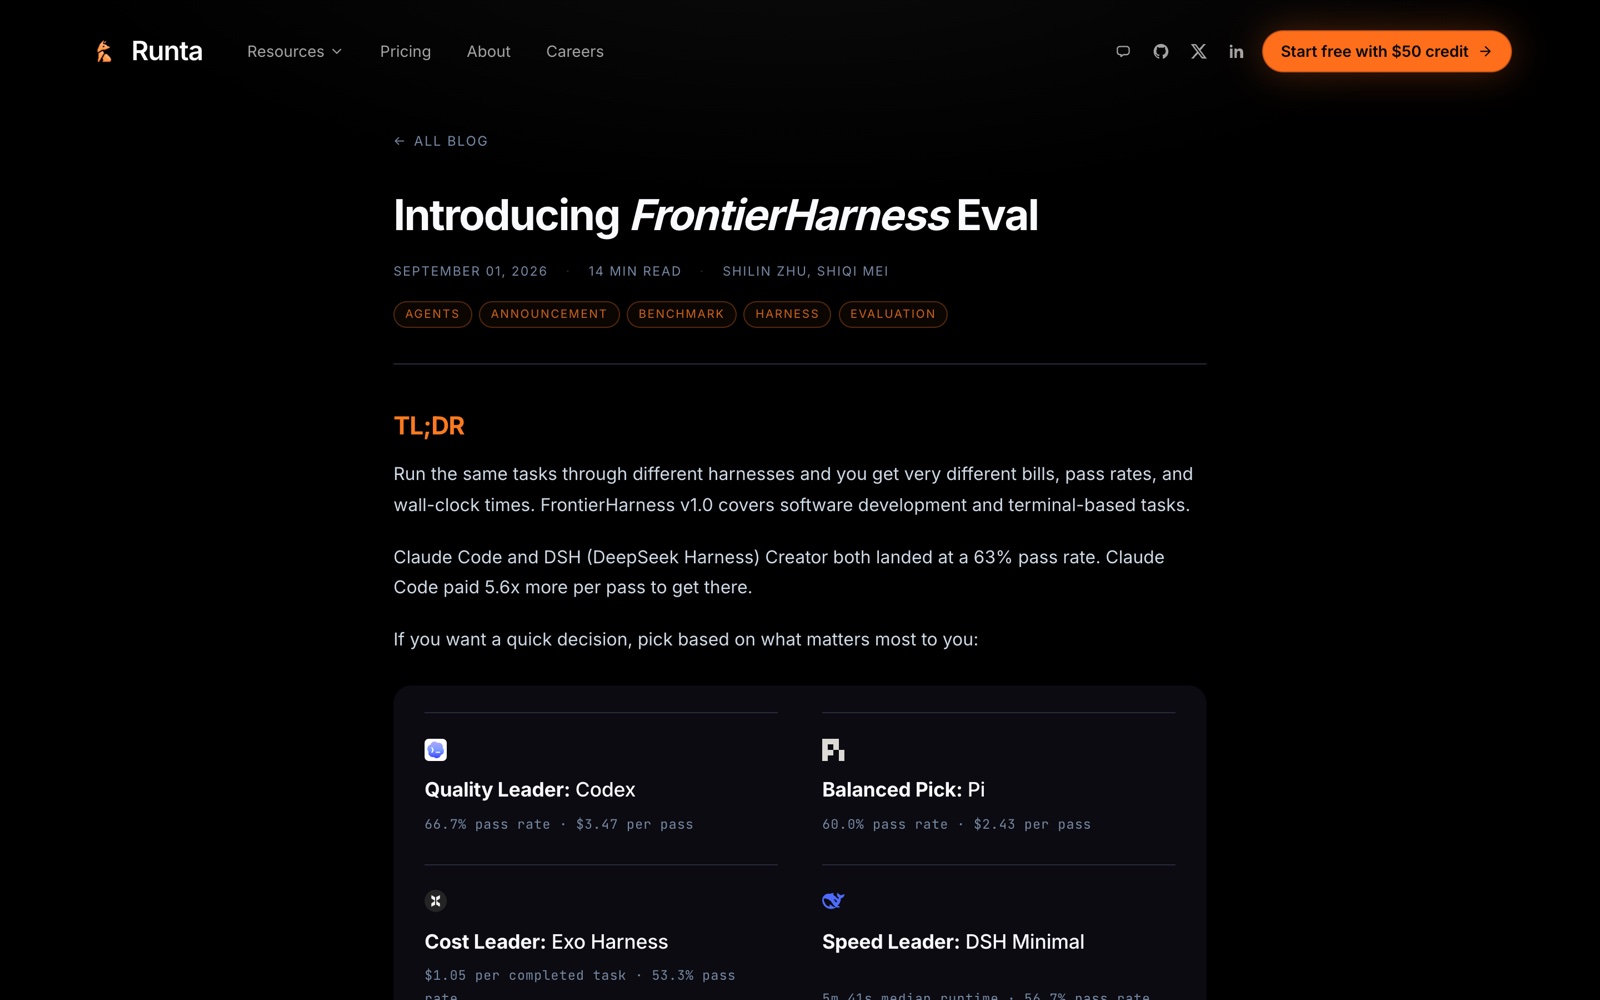
Ключевые числа из сводной таблицы:
| Harness | Стоимость за pass | Pass rate | Кеш-хит |
|---|---|---|---|
| Codex | $3,47 | 66,7% | 88,0% |
| DSH Creator | $3,28 | 63,3% | 84,3% |
| Claude Code | $18,34 | 63,3% | 67,8% |
| Pi | $2,43 | 60,0% | 79,4% |
| Exo Harness | $1,05 | 53,3% | 70,3% |
Разброс pass rate — от 50,0% до 66,7% (17 пунктов), разброс цены за решённую задачу — от $1,05 до $18,34. «Какая обвязка качественнее» и «какая дешевле» оказались разными вопросами. Внутри одного протокола DSH вообще четыре пресета одной обвязки дали 6,6 пункта разницы по pass rate и 1,4× по цене — это примерно столько же, сколько разница между разными harness’ами.
Три эффекта, из-за которых счёт раздувается
Prefix-кеш ломается от одной правки. Prefix — статическая часть контекста (system prompt, история). Если в начало подсунуть динамический элемент — дату или меняющийся UUID, — всё, что после него, перестаёт кешироваться. В imec поймали конкретный релиз: Claude Code v2.1.233 дал средний кеш-хит 29,84% против 97,36% у пропатченной версии (issue #87227). Работа та же, счёт — в разы больше.
Doom loop — платный простой. У Pi один-два worker-агента застревали в цикле, пока оркестратор не убивал их по лимиту в 4 часа. Результаты для Pi в статье скорректированы по «здоровым» прогонам, но в реальной инфраструктуре эти часы вы всё равно оплачиваете.
Провалы тоже стоят денег. Соавтор Runta в комментариях на HN напоминает, что бесплатных попыток не бывает. На самой тяжёлой задаче (python-statemachine-state-data-scoping) семь конфигураций прошли её, но счета отличались в 26 раз: Pi решил за $2,50 (90 шагов, кеш 98,2%), а Claude Code — за $64,36 (381 шаг, кеш 15,7%).
Что это значит для выбора агента
Практический вывод простой: если вы платите за токены API, стоимость за решение задачи — главная метрика, а pass rate — маркетинговая. Если вы арендуете или покупаете GPU, всё определяется wall time: часы простоя GPU при reasoning и вызовах тулов уходят в счёт независимо от того, продвинулся агент или нет.
Минимальный набор телеметрии, который стоит поднять у себя, выглядит так:
# из логов агента: считаем не только pass rate, но и цену решения
# 1) сколько токенов уходит на задачу без учёта кеша
jq -r '.usage | (.input_tokens + .output_tokens)' run.jsonl | paste -sd+ | bc
# 2) доля кеш-хитов по всем вызовам (а не только по median)
jq -r '.usage.cache_read_input_tokens / (.usage.input_tokens + .usage.cache_read_input_tokens)' run.jsonl \
  | awk '{s+=$1; n++} END {printf "weighted cache hit: %.1f%%\n", 100*s/n}'
# 3) стоимость прогона = wall time × ставка, а не только токены
echo "scale=2; $WALL_HOURS * $GPU_RATE_PER_HR" | bc
Стоит держать в голове: и imec, и Runta прямо предупреждают, что их числа описывают конкретную пару «harness + модель + бэкенд», а не обвязку в вакууме. Claude Code с Anthropic-моделями и нативным кешем работает иначе, чем с Kimi K3 через сторонний шлюз. Переносить вывод «Codex дешевле Claude Code» на вашу комбинацию без своего замера нельзя.
Российские реалии
Обе обвязки — зарубежные продукты, и это определяет доступность:
- Установка. CLI-агенты (Claude Code, Codex) ставятся штатно через npm и не блокируются из РФ, но авторизация привязана к зарубежному аккаунту.
- Оплата. Российские Visa и Mastercard не принимаются. Рабочие каналы — виртуальные зарубежные карты с пополнением по СБП или USDT, карты банков Казахстана, Грузии, Армении. Разбор вариантов и рисков перекупщиков — «Как оплатить подписку ChatGPT из России» на Habr.
- VPN. Для входа в Anthropic и OpenAI по OAuth российский IP не подходит; API-ключ работает стабильнее.
- Бенчмарки на русском. Тему стоимости агента в рунете разбирают мало и в основном через призму «свой замер». Полезны: «Как тестируют кодинг-агентов в 2026 — и почему вашему продакшну нужен свой бенчмарк» (там же — расхождение лидеров на приватном коде), разбор графиков Cursor о публичных бенчмарках и экономика self-hosted против API. Готовых русскоязычных замеров именно harness-стоимости, сопоставимых с imec и Runta, на момент публикации нет — это признаёт и сама выдача.
Ограничения
- Выборка маленькая. У imec — 64 задачи, у Runta — 30. Один харнесс решает на 2–3 задачи больше — это не «лидерство», а шум.
- Обе работы — вендорские или коммерческие. За Runta стоит продукт agent execution layer, поэтому их лидерборд стоит читать как аргумент в маркетинге, а не как нейтральную науку.
- Стабильность версий. Числа меняются от релиза к релизу: кеш-аномалия Claude Code и doom loop у Pi — временные, но именно они формировали счёт на момент замера.
- Не-AI-задачи не покрыты. FrontierHarness v1.0 — только разработка и терминал; переносить выводы на документооборот или аналитику нельзя.
- Модель подменяет картину. Оба замера фиксируют модель, но взаимодействие «обвязка × модель» пока не изолировано — это заявленный план на v1.1.
Вывод
Вопрос «какой агент лучше» в 2026 году стоит заменить на «сколько мне стоит решённая задача в моей обвязке». Точность популярных harness’ов сблизилась — выбирайте по вкусу. А вот счёт отличает их в разы, и управляют им не «ум» модели, а инженерия контекста, стабильность кеша и лимиты шагов. Если запускаете агентов пакетно, заведите телеметрию по токенам и wall time до того, как включите автоматизацию на полную.
Связанные статьи
- Claude Code vs Cursor vs ZCode — сравнение агентов по интерфейсу и сценариям
- Модели для кодинга 2026 — какие модели актуальны и как их измеряют
- Кейс: как ускорить агента в разы (Bullet) — оптимизация обвязки на практике
- Claude Code через API — оплата по токенам и её подводные камни
Читайте также: Сколько стоит ИИ-агент в 2026: цены, подписки и оплата из России · Кейс: анатомия harness engineering: как измерить и ограничить ИИ-агента
