Два инженера Google, Taylor Mullen и Christian Gunderman, опубликовали 9 сентября 2026 года разбор под названием «The Anatomy of Harness Engineering» (Google Developers Blog). Их тезис бьёт по привычке мерить агента одной цифрой бенчмарка: когда вы запускаете Terminal-Bench или DeepSWE и видите, что композитный балл сдвинулся на пару процентов, вы понятия не имеете, почему. Модель стала самоувереннее на расплывчатых промптах? Забыла прогнать тесты перед сдачей? Выдумала флаг CLI? Один балл на эти вопросы не отвечает. Ниже — перевод и адаптация их подхода применительно к вашему репозиторию.
Что такое harness
Слово «harness» в контексте агентов переводят как «упряжь» или «обвязка». Это всё, что стоит вокруг модели и что вы реально контролируете: системный промпт и правила, набор инструментов и их схемы, разрешения и запреты, механизм проверок. Сама модель при этом — самая быстро меняющаяся и наименее управляемая часть. Источник формулирует это прямо: основная задача оценочного набора не в том, чтобы «отпраздновать улучшение на 2%», а в том, чтобы «дать вам несокрушимую уверенность в том, что новая правка промпта, изменение схемы инструмента или апгрейд модели не сделали агента хуже в целом».
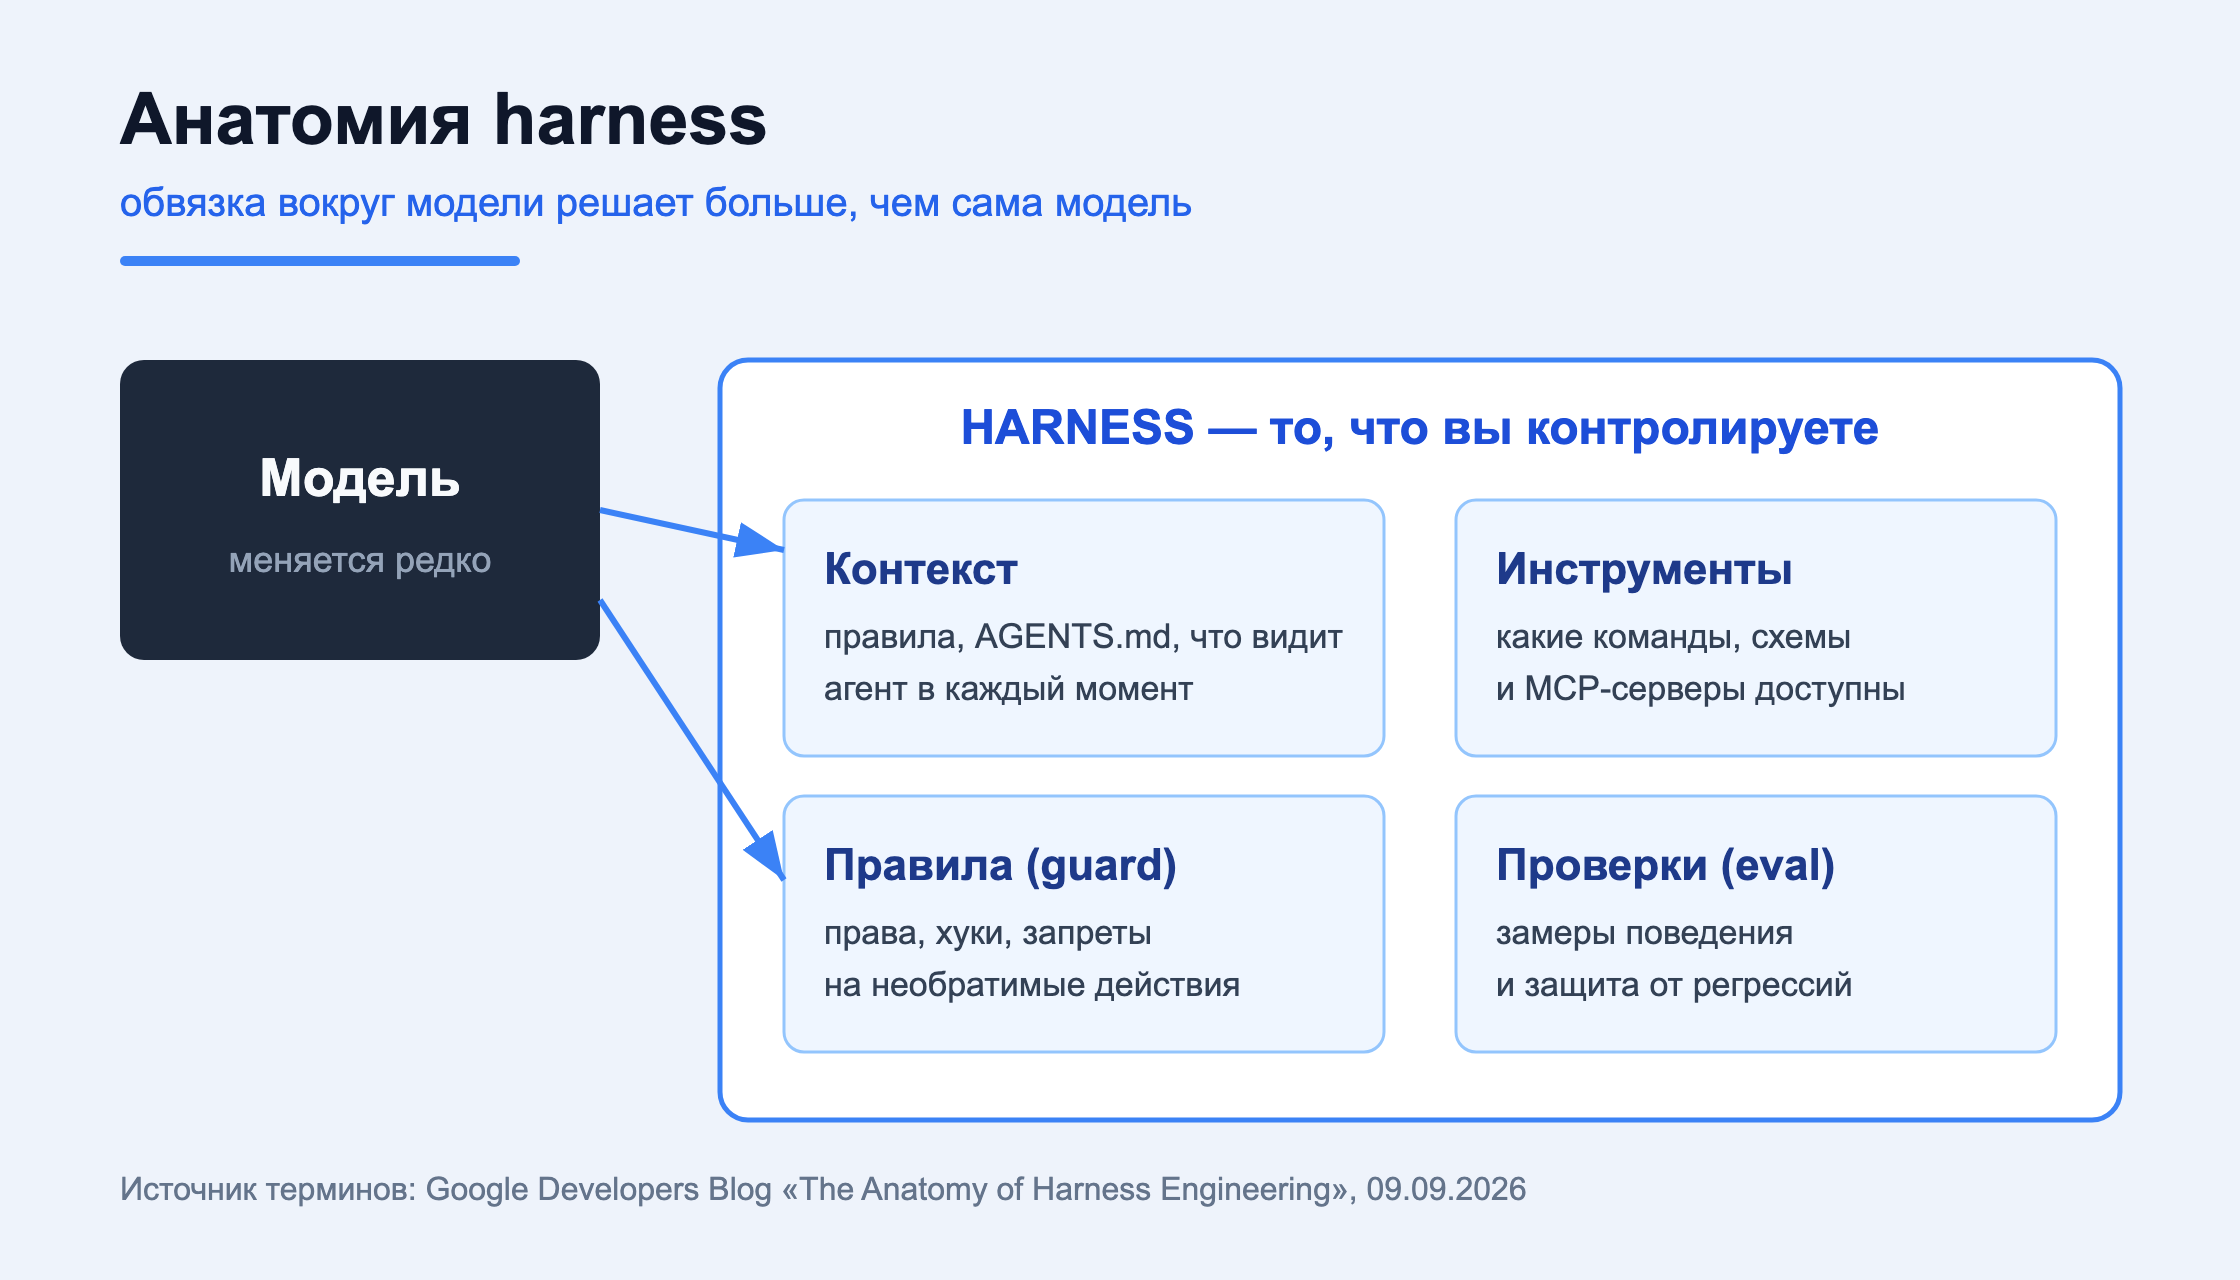
Модель — чёрный ящик на сервере провайдера, harness — стандартный софт, который вы пишете и тестируете сами. И который определяет результат сильнее, чем выбор модели.
Evaluate: как замерить агента на своих задачах
Google предлагает заменить «экзамен» на поведенческие проверки. Разница принципиальная. End-to-end бенчмарк прогоняет агента по большой кодовой базе и считает, сколько тестов прошло. Поведенческий eval измеряет дискретные наблюдаемые действия:
- на недоспецифицированный промпт агент задаёт уточняющий вопрос, а не угадывает;
- при правке сборочного файла он запускает локальный валидатор прежде, чем объявить работу завершённой;
- при генерации документации он даёт канонические ссылки на репозиторий.
Из источника приведён короткий пример на pytest, где проверяется не текст ответа, а сам факт вызова поискового инструмента:
import pytest
from google.antigravity import Agent, LocalAgentConfig, types

@pytest.mark.asyncio
async def test_agent_uses_web_search_for_live_weather():
  """Assert that the agent consults ground truth rather than guessing."""
  config = LocalAgentConfig()
  async with Agent(config) as agent:
    response = await agent.chat("What's the weather like in Mountain View, California?")
    tools = [call.name async for call in response.tool_calls]
  # Assert behavior, not output prose
  assert types.BuiltinTools.SEARCH_WEB in tools
Цитата в переводе: «Поведенческие проверки работают как интеграционные тесты для улучшения работы harness агента». Идея в том, что каждое ожидаемое поведение превращается в отдельное утверждение на промежуточном шаге, а не на финальной строке ответа.
Ещё один важный пункт от Google — про порядок работы. На старте eval не нужен: пока агент не может «догфудить» собственный кодовый базис и решать рутинные задачи, замерять нечего. Оценка нужна на второй фазе — чтобы удерживать движение вперёд и защищаться от регрессий.
Iterate: что менять по результатам замеров
Когда у вас есть набор поведенческих проверок, появляется возможность автоматизировать инженерию промптов. Источник описывает цикл, в котором LLM правит собственный системный промпт до тех пор, пока падающий тест не начнёт проходить, — а весь остальной набор тестов в это время играет роль CI-заграждения. Это и есть обучение на собственных провалах: не «мне кажется, промпт стал лучше», а «конкретные три теста из набора теперь стабильно зелёные».
Трёхшаговый цикл, который Google рекомендует как отправную точку:
- Возьмите один провалившийся сценарий. Не абстрактное «агент глупеет», а конкретное: «в прошлый раз он не запустил unit-тесты перед завершением задачи».
- Пишите гибкие утверждения. Для простых задач с единственным решением годится строгая проверка одного шага (вызван ли test-runner). Для сложных не заставляйте агента идти строгой последовательностью инструментов — используйте мягкие проверки по результату, вроде «LLM-как-судья».
- Гоняйте пакетные прогоны. Не блокируйте каждый PR одной прогонкой (ИИ недетерминирован, один прогон шумит), а собирайте агрегированную статистику и следите за трендом.
Команда для локального прогона поведенческого набора прямо из статьи:
# Run local behavioral suite in under 5 seconds
pytest evals/behavioral/ -v
Смысл этого цикла простой: правки промпта, новые инструменты и апгрейды моделей должны быть безопасными операциями, а не лотереей.
Guard: как ограничить права и необратимые действия
Третий столп — ограничения. Google описывает guard как отдельную часть harness, но не даёт конкретных механизмов; их стоит взять из документации живых инструментов. Собрал сводку «риск → guardrail» по официальным источникам:
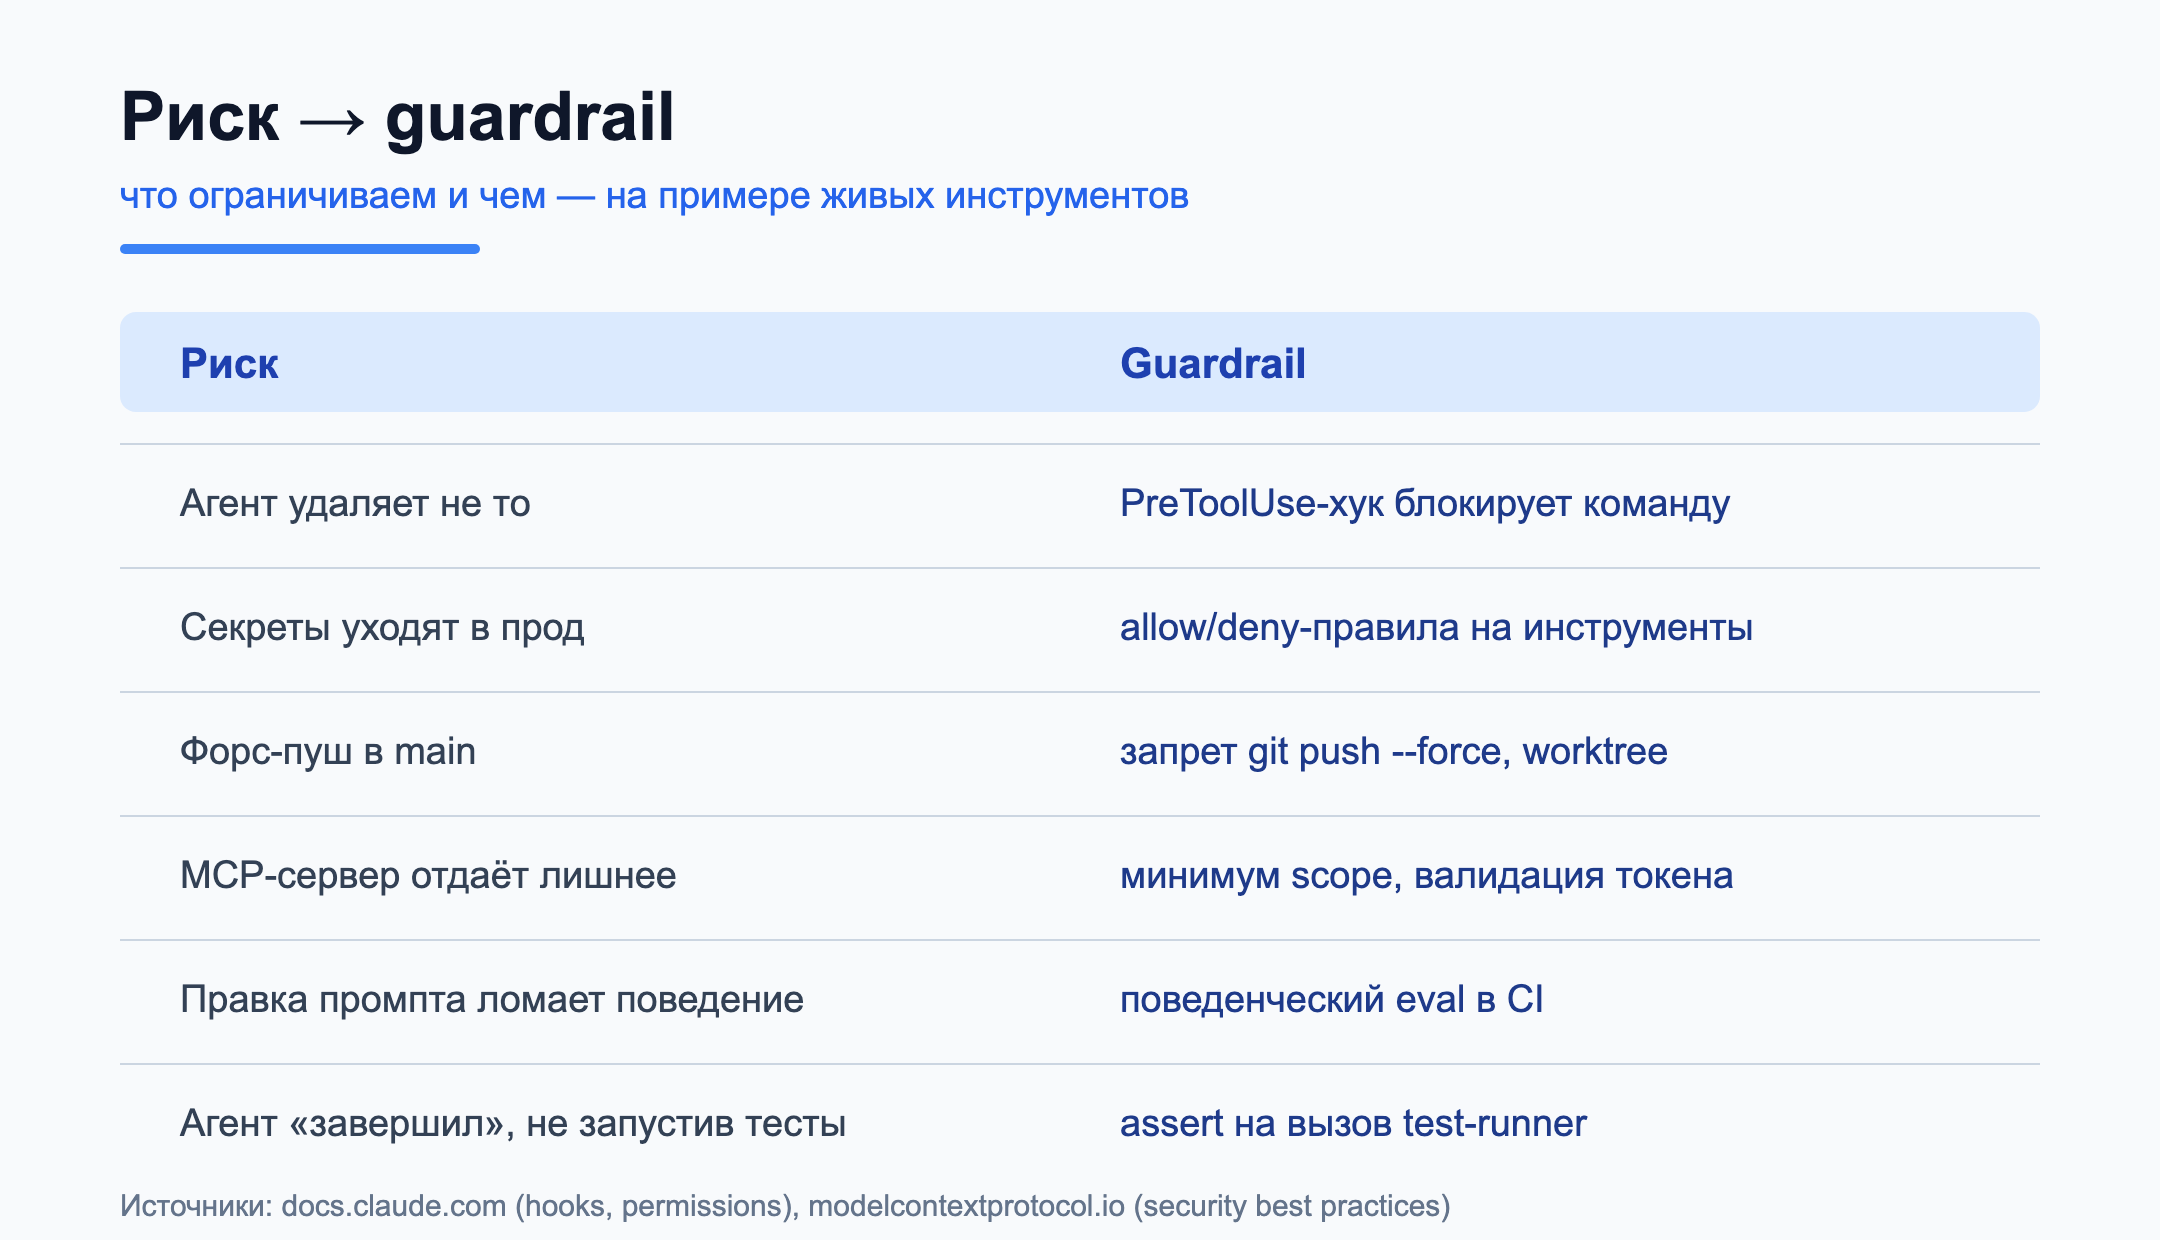
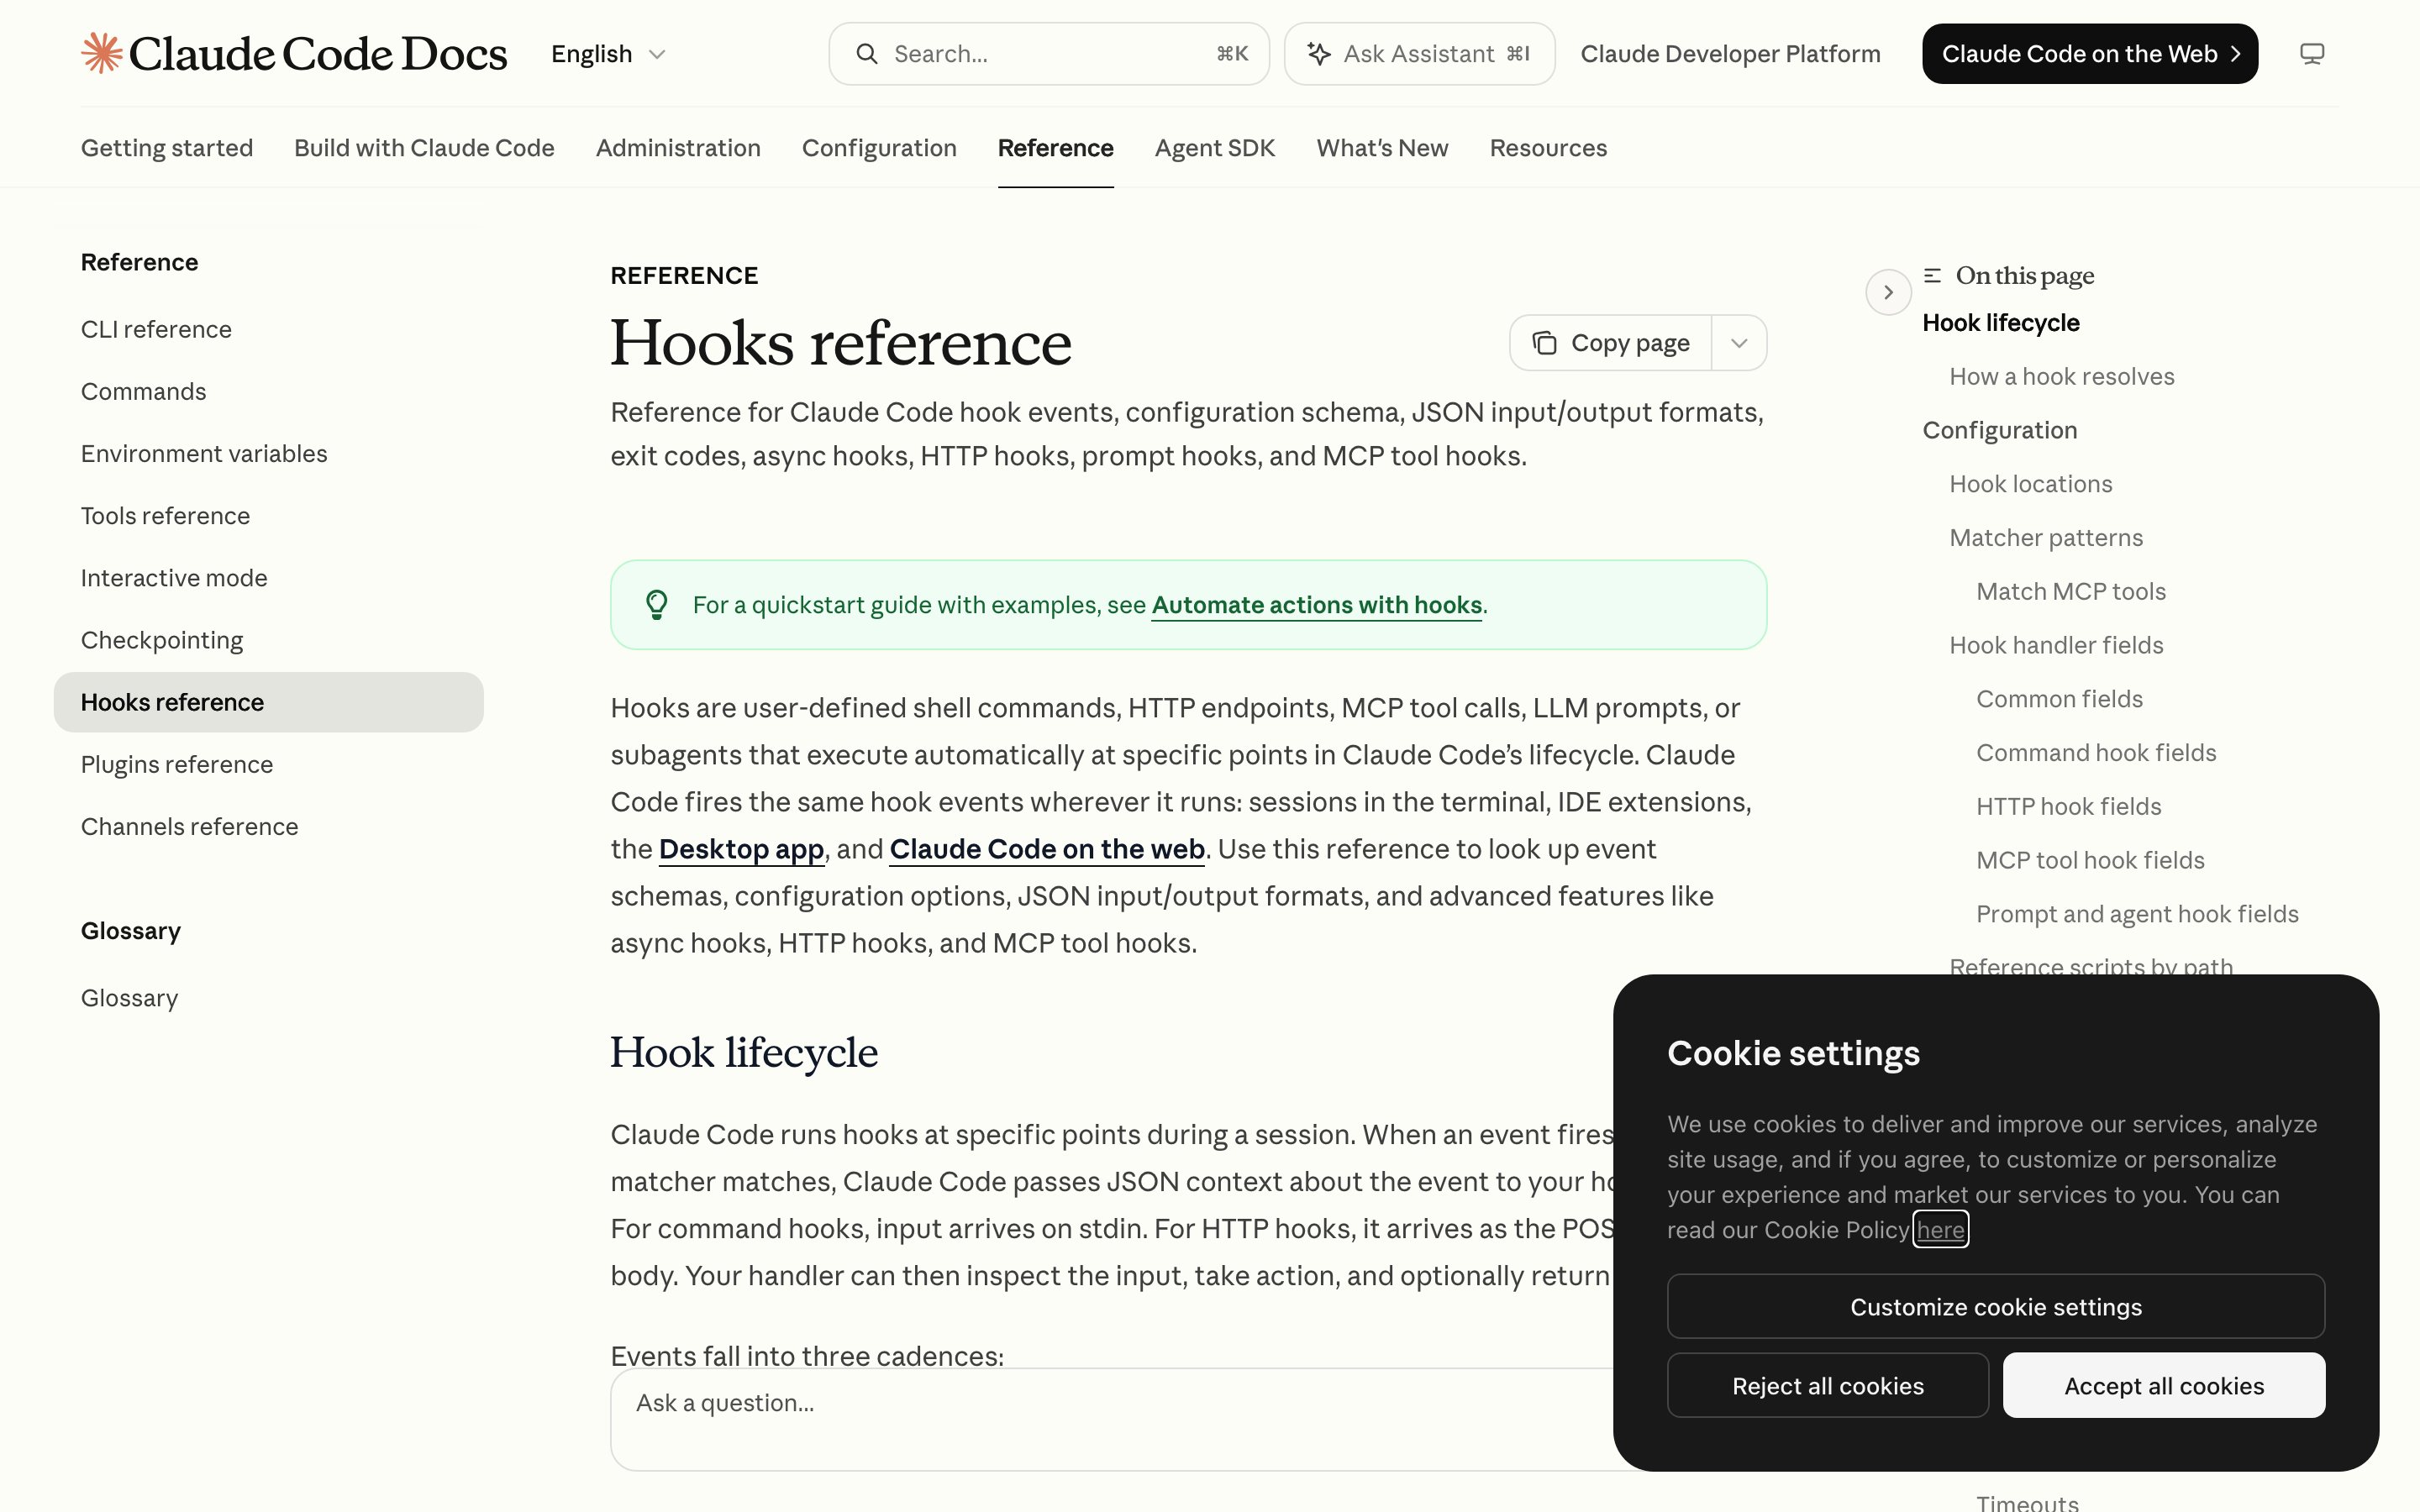
У Claude Code есть система хуков — «пользовательских shell-команд, HTTP-эндпоинтов, вызовов MCP-инструментов, LLM-промптов или субагентов, которые выполняются автоматически в определённых точках жизненного цикла» (Hooks reference). Событие PreToolUse срабатывает до вызова инструмента и может его заблокировать; PostToolUse — после успешного вызова, туда логично вешать запуск тестов. Хук с кодом выхода 2 блокирует действие и возвращает агенту причину.
Про MCP-серверы отдельная тема: официальный документ Security Best Practices (спецификация 2025-11-25) прямо запрещает «token passthrough» — когда сервер принимает токен клиента и передаёт его дальше в downstream-API, не проверив, что токен выдан именно ему. Там же описана атака confused deputy и требование минимизировать scope: начинать с базового набора прав и повышать их точечно, а не выдавать один omnibus-scope со звёздочкой.
Минимальный набор метрик для команды
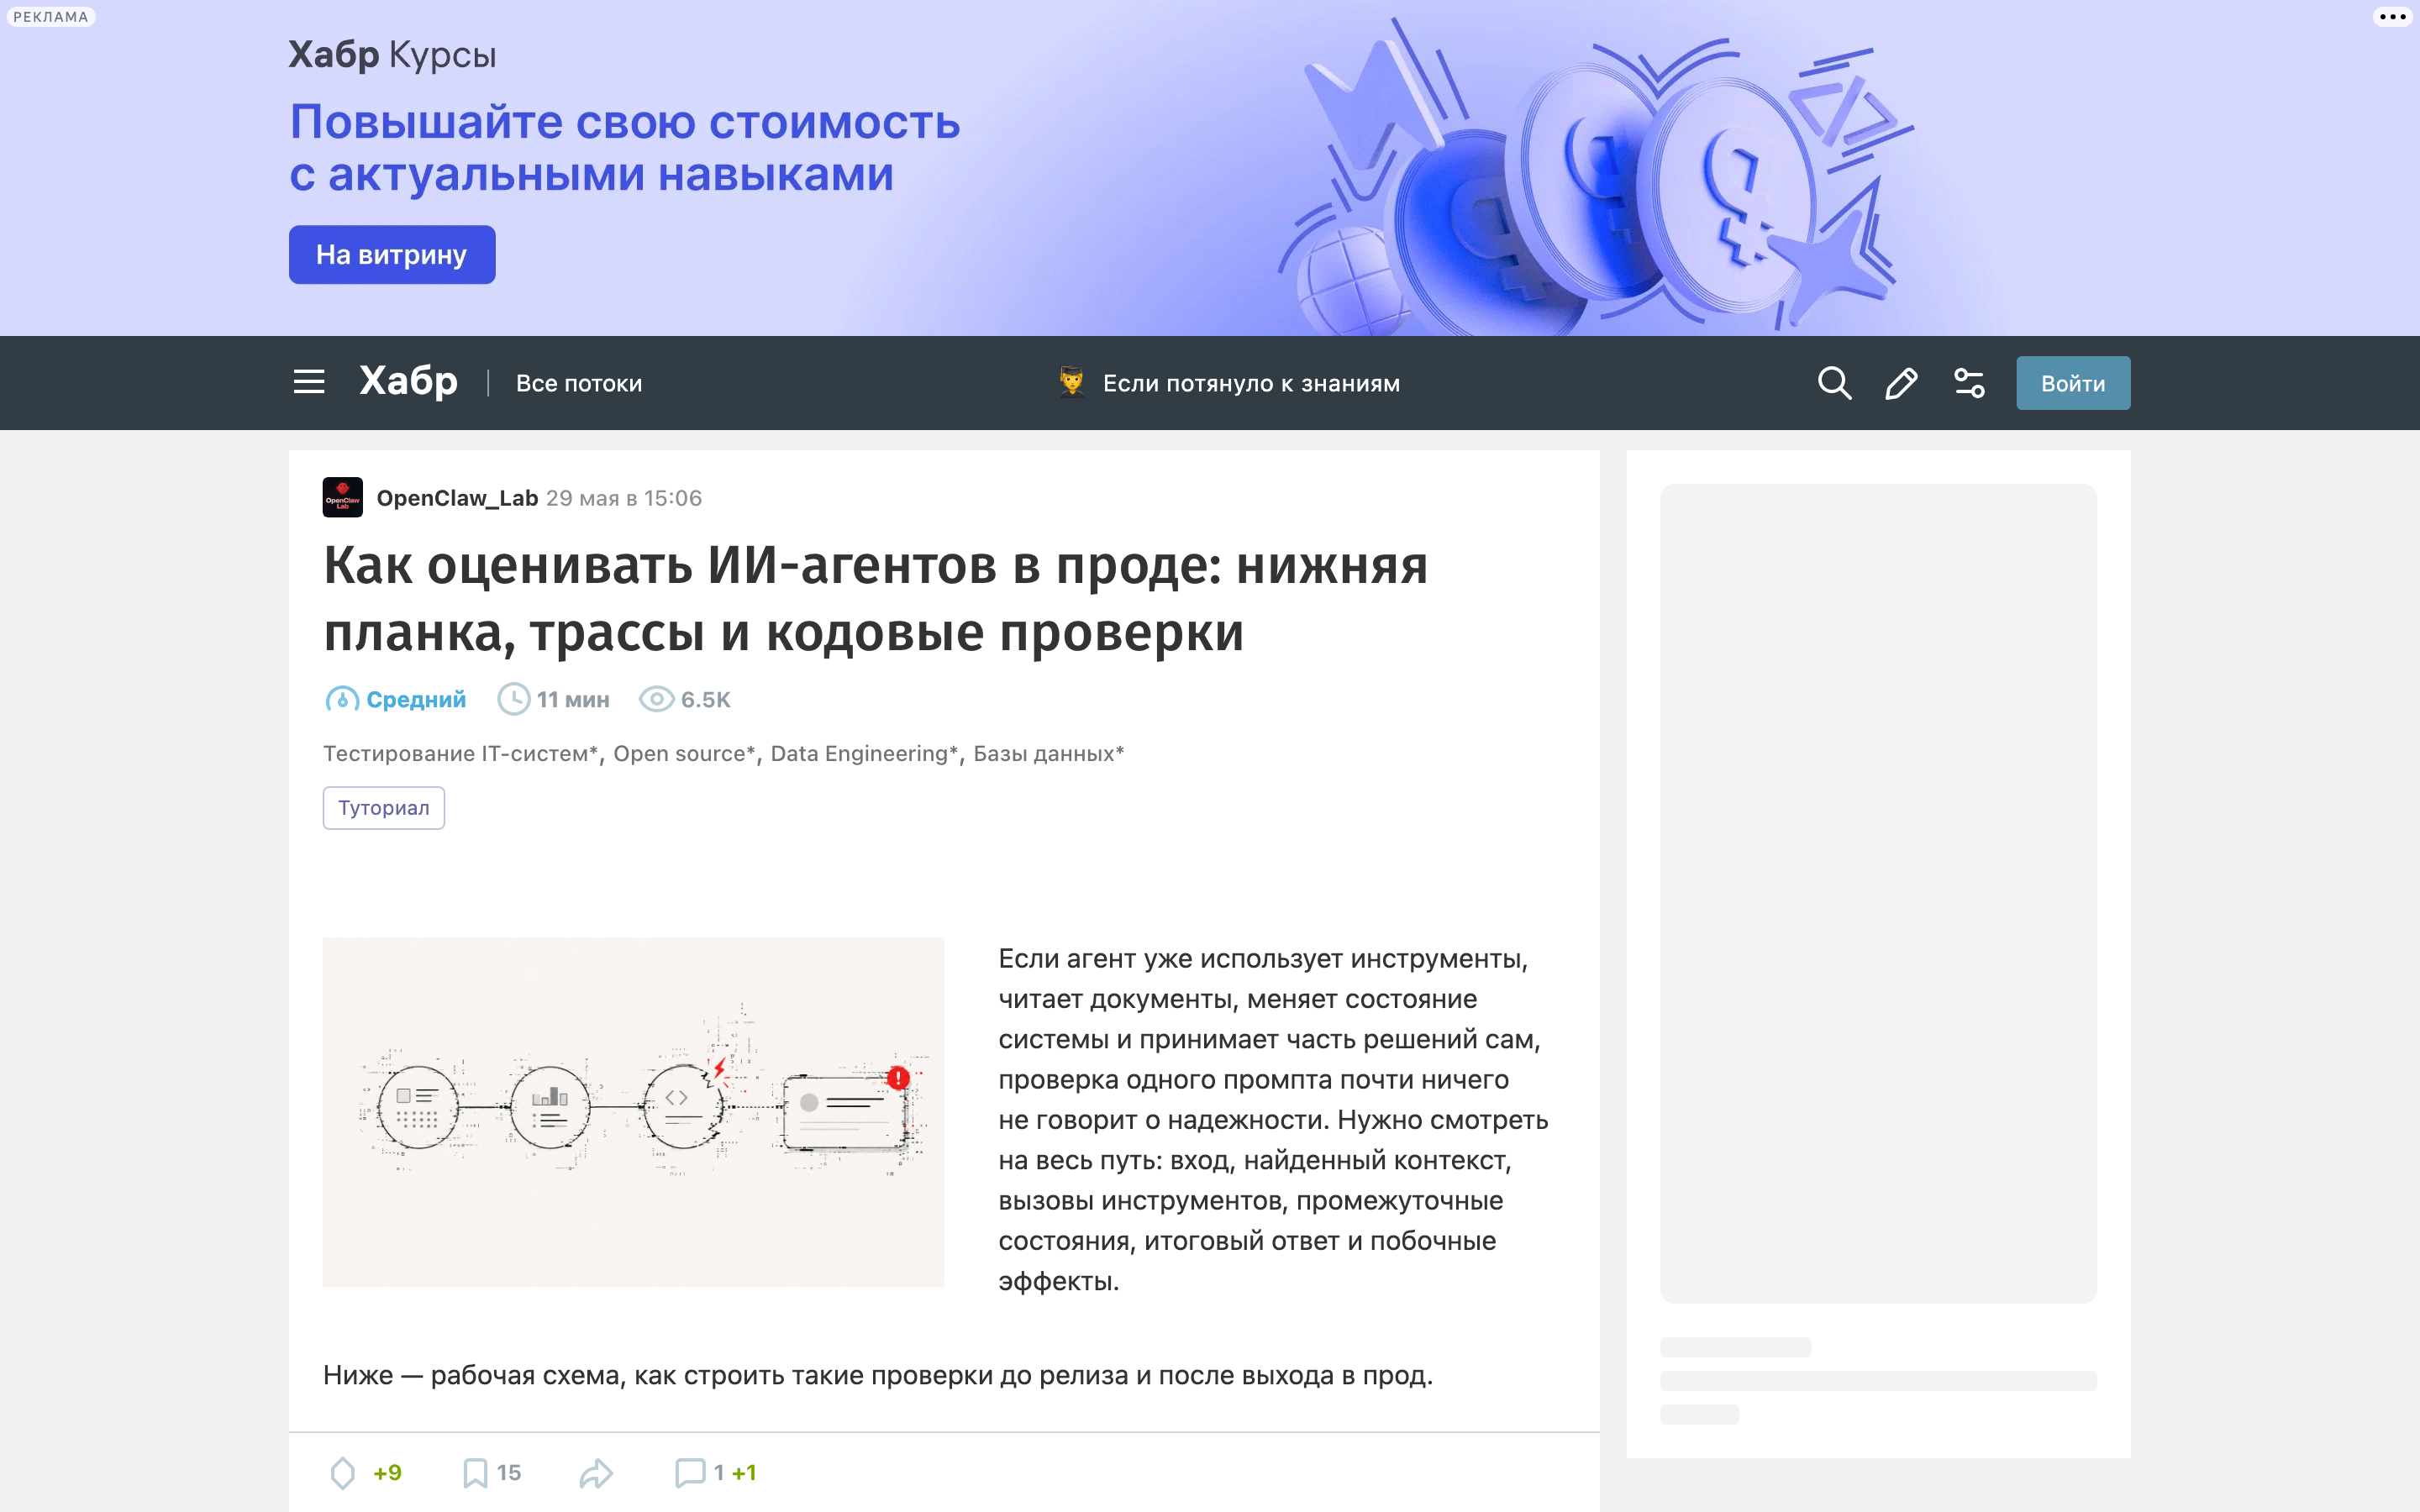
Если сводить всё к тому, что реально стоит снимать, получится короткий список. Использую разбивку из Habr-гайда «Как оценивать ИИ-агентов в проде»: оценивать надо «весь путь агента, а не только финальный ответ: какие инструменты вызывались, с какими аргументами, какие ошибки появились, что изменилось в состоянии системы».
| Метрика | Что показывает | Как снимать |
|---|---|---|
| Success rate сценария | доля задач, решённых без человека | прогон набора из 20–50 реальных задач |
| Tool-call accuracy | верно ли выбран инструмент и аргументы | assert на вызовы из трейса |
| Pass rate поведенческого набора | тренд, а не абсолютное значение | пакетные прогоны, агрегат по времени |
| Лишние шаги | стоимость и «глупые» циклы | число вызовов на задачу из трейса |
| Cost per successful task | экономика | токены × цена, делённые на success rate |
| Число срабатываний guardrail | как часто правила реально ловят | логи хуков и денайлов |
Из Habr-статьи про метрики, тестирование и LLM-as-a-Judge стоит добавить важное: evaluation начинается с тестового набора, а не с выбора модной метрики. Тестовый кейс может содержать не эталонный ответ, а «ожидаемое поведение» с категорией и уровнем риска. И там же — предупреждение про смещения LLM-судьи: позиционное и в пользу более подробных ответов. Поэтому кодовые проверки (JSON-схема, точные значения, сам факт вызова инструмента) надёжнее, где это возможно.
Российские реалии
Harness engineering как термин в рунете ещё не устоялся: поиск по «harness engineering» даёт в основном англоязычные материалы, русскоязычных статей именно с этим словом почти нет. Зато сама практика — оценка агентов, метрики, guardrails — на Habr уже разобрана подробно и без вендорлока:
- «Как оценивать ИИ-агентов в проде: нижняя планка, трассы и кодовые проверки» — офлайн-eval как обычный тест в pytest/Vitest, локальный отчёт по трассам;
- «Как оценивать качество LLM, RAG и AI-агентов: метрики, тестирование и LLM-as-a-Judge» — набор свойств ответа и предупреждение про смещения судьи;
- «AI-агенты в проде: как оценивать качество, стоимость и стабильность» — метрики CPS (Cost per Session) и CPR (Cost per Successful Resolution), а также разбор Error Rate по категориям.
Инструменты и доступ из РФ. Хуки, разрешения и eval-наборы настраиваются на стороне клиента, то есть на вашей машине или в вашем CI, — и работают независимо от того, есть ли у вас доступ к облачным сервисам Google. Ограничение здесь инфраструктурное: если вы арендуете Google Cloud для запуска агента (Antigravity SDK, Vertex AI), понадобятся обход гео-ограничений и зарубежная карта — российские Visa и Mastercard отключены от процессинга. Приватные CI-раннеры и локальные модели снимают зависимость от облака полностью.
Честные ограничения
- Источник — методология, а не отчёт о внедрении. Google описывает подход и один короткий пример на pytest для Antigravity SDK, но не приводит цифр из продакшена: сколько задач в наборе, на сколько вырос pass rate, сколько это стоило. Всё, что подаётся как «должно работать», в источнике не измерено на публичных данных.
- Термин размыт. У Google harness — это обвязка вокруг модели, но в других материалах под harness иногда понимают только тестовую инфраструктуру. Я держусь определения из источника, но это не единственное употребление.
- Пример кода — под конкретный SDK. Фрагмент импортирует
google.antigravityи классыAgent,LocalAgentConfig,types. Перенести его на другой агент нельзя без переписывания; здесь важен принцип «assert на промежуточный шаг». - Ссылка на HN пуста. Тред на Hacker News по этой статье (2 балла, без комментариев на 10.09.2026) не добавляет ничего к смыслу.
- LLM-как-судья не бесплатен и не точен. Мягкие проверки через судью требуют отдельного бюджета токенов и имеют известные смещения. Для простых поведений кодовые утверждения дешевле и надёжнее.
Вывод
Практический вывод из разбора Google простой: если у вас агент выдаёт разный результат на одной и той же задаче, дело почти всегда не в модели, а в harness. И лечится это не сменой модели, а тремя вещами — замером поведения на своих задачах, итерацией промпта и инструментов по результатам, и явными ограничениями на необратимые действия.
Порядок действий для одной команды такой: заведите набор из 10–20 реальных задач, напишите по одной поведенческой проверке на самые частые провалы, прогоняйте пакетно в CI и следите за трендом, а хуки настройте в первую очередь на удаление файлов, форс-пуш и секреты. Это займёт день-два и даст то, чего не даёт ни один бенчмарк.
Связанные статьи
- Контекст ИИ-агента — что именно видит агент и как это устроено
- Песочницы для ИИ-агентов — ещё один способ ограничить необратимые действия
- Безопасность ИИ-агентов — угрозы, которые закрывают guardrails
- Промпт-кеширование — что ещё определяет результат агента, кроме модели
- Agile AI DLC: методология — где место замерам в цикле разработки
Читайте также: Кейс: Claude Code, Codex и Pi на SWE-Bench Pro: одна точность, двойная цена · Настройка ИИ-агента под свой проект: чек-лист из 10 шагов
