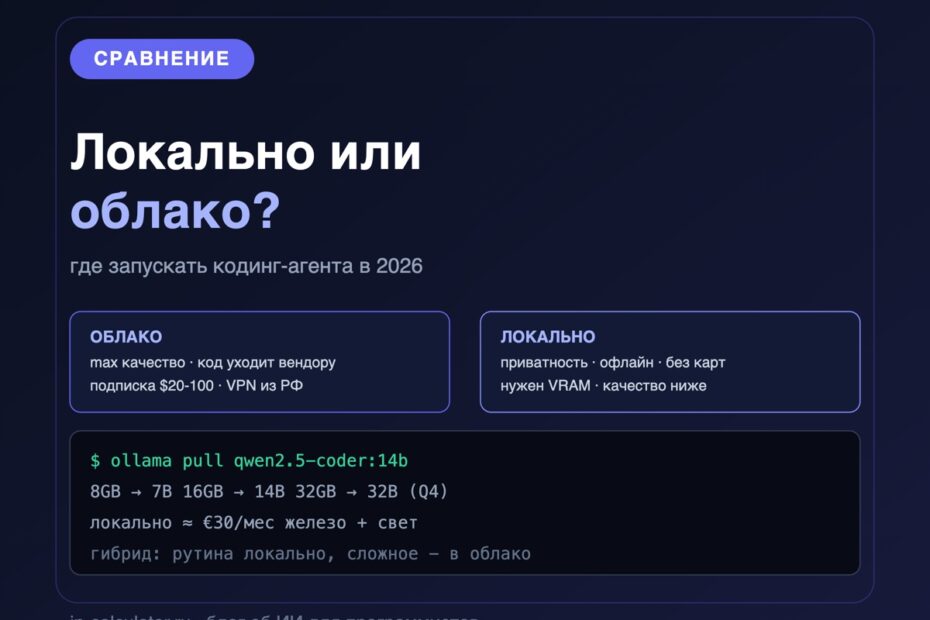
«Claude Code или Codex?» — вопрос, который задают чаще, чем «где это должно крутиться». Между тем решение о запуске меняет три вещи сразу: уходит ли ваш код на чужой сервер, сколько вы платите и что вы можете сделать без интернета. По Wordstat «claude code локально» — 282 показа в базе и 32 в точной форме, «локальные модели 2026» — 155 при нуле в точной; тема ещё не разобрана в рунете системно. Ниже — три схемы запуска, что реально тянет железо и как считать стоимость, не обманывая себя.
Три схемы, а не две
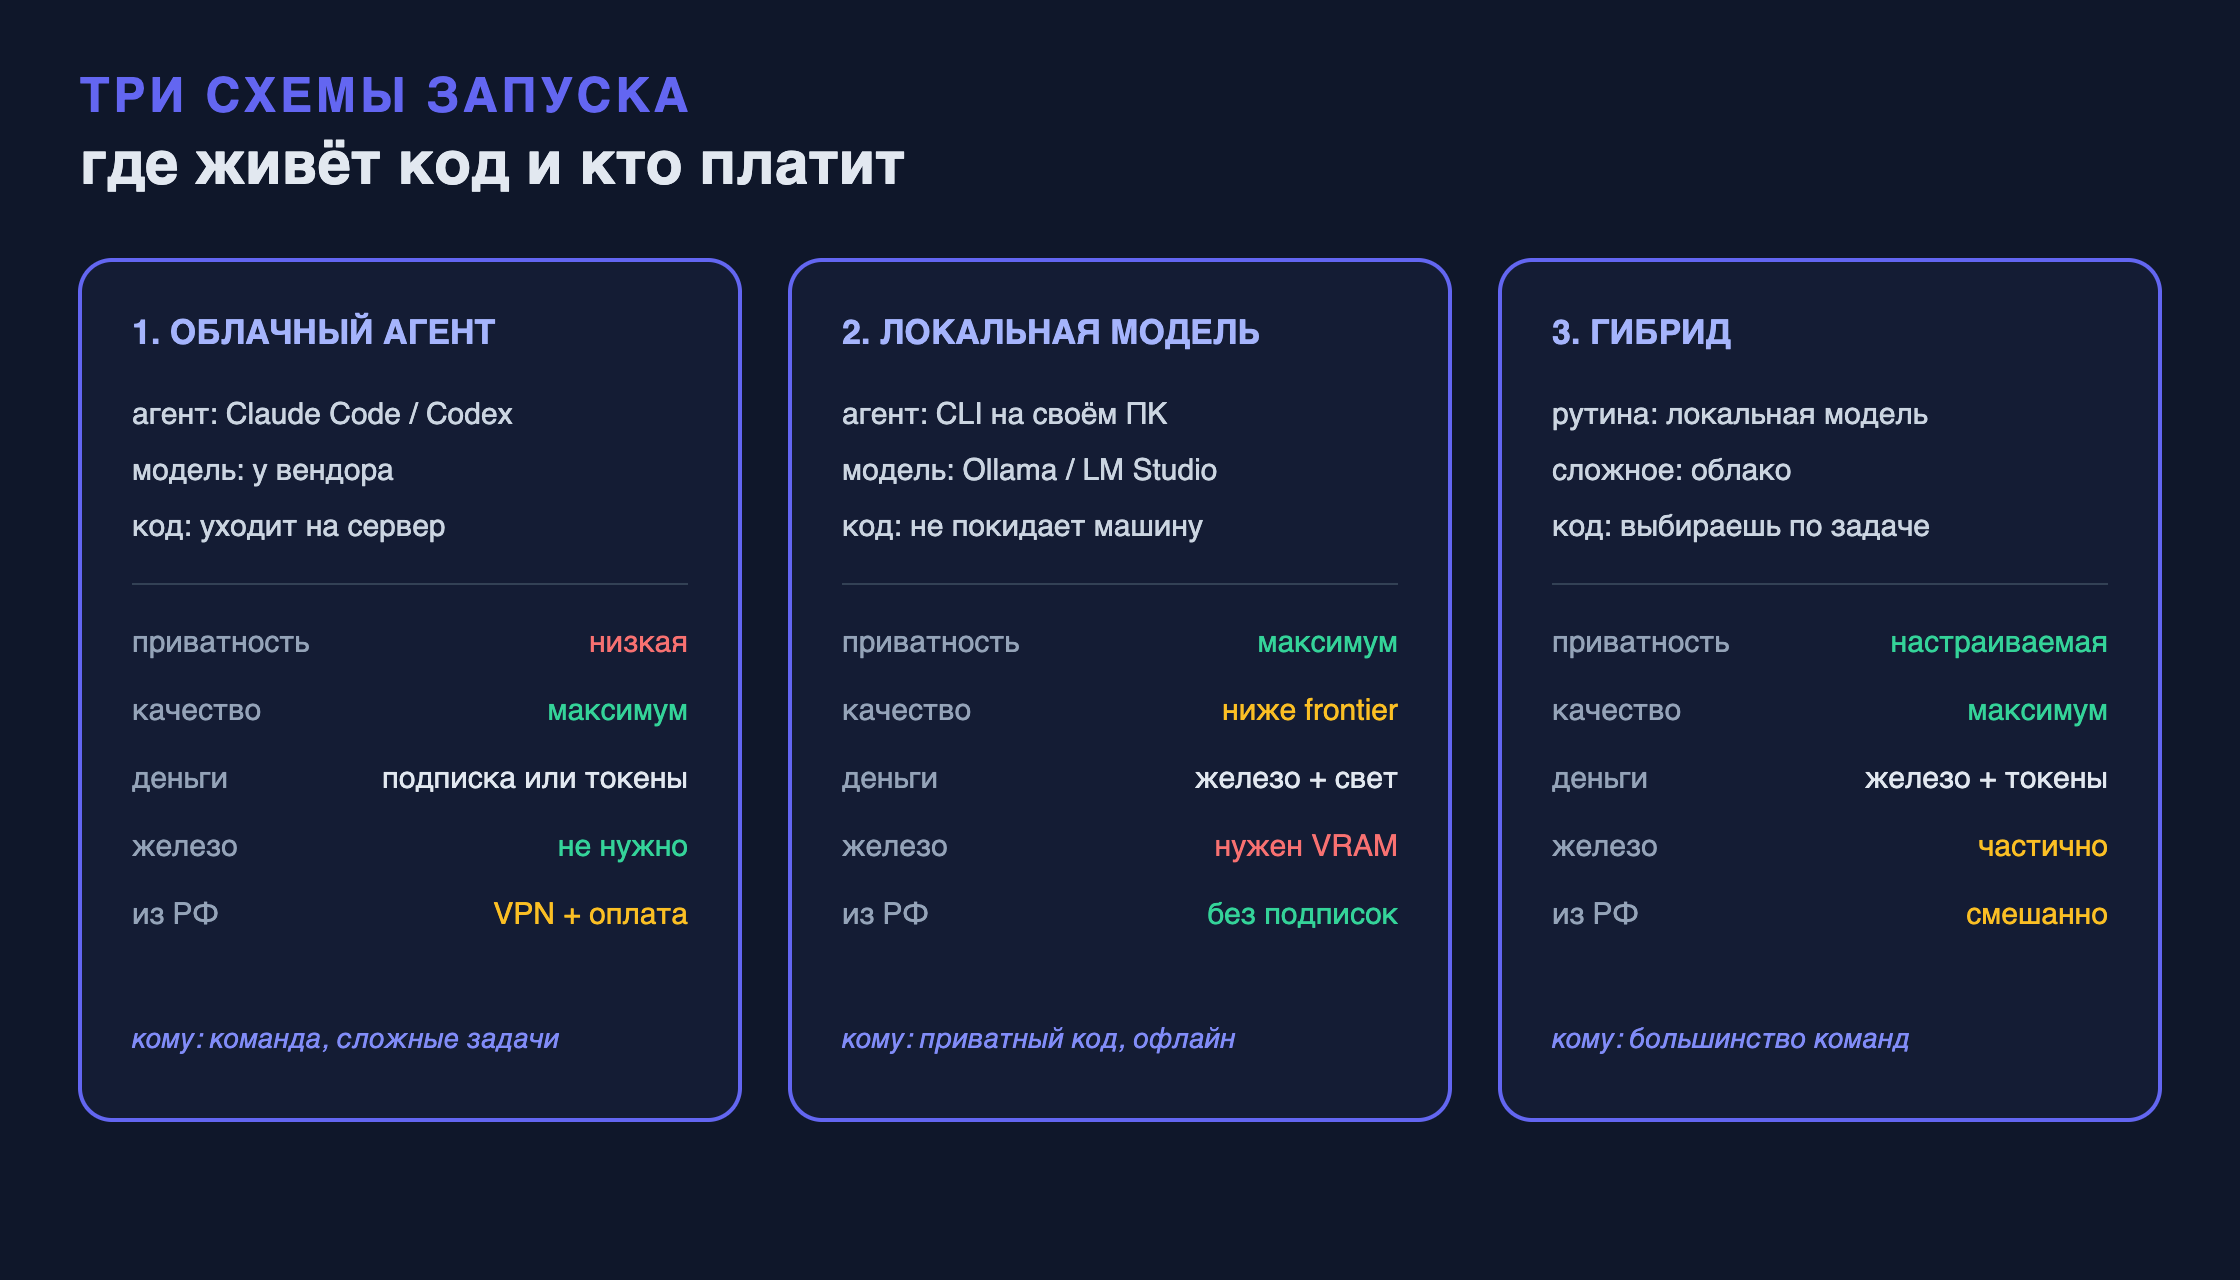
Выбор не сводится к «облако против локально». Есть промежуточный вариант, который в 2026-м выбирает большинство команд:
| Схема | Приватность | Качество | Деньги | Кому подходит |
|---|---|---|---|---|
| Облачный агент | низкая: код уходит вендору | максимум (frontier-модель) | подписка или оплата за токены | команда, сложные задачи, есть валюта для оплаты |
| Локальная модель + CLI | максимум: код не покидает машину | заметно ниже frontier | один раз железо + электричество | приватный код, офлайн, ограниченный бюджет |
| Гибрид | настраиваемая | максимум там, где нужно | железо + токены | большинство команд |
Что решает приватность на практике
Локальный запуск — это не про политику, а про физику: если модель работает на вашей машине, код физически не может утечь к вендору. Но важна деталь: «локально» относится к модели, а не к агенту. CLI-агент всё равно может ходить в сеть за погодой, документацией или MCP-сервером, если вы это разрешили. Проверьте, что именно уходит наружу, прежде чем считать схему приватной.
Второй нюанс — где вы хотите выполнять агента, а не где его модель. Dan Hopwood в разборе «Running coding agents on a €30 Linux box» описывает третий путь: агенты вообще не на ноутбуке и не в облаке вендора, а на дешёвом постоянно включённом Linux-сервере (Netcup, 12 ядер, 32 ГБ, около €30 в месяц). Логика простая: сессия агента не должна умирать от закрытой крышки ноутбука.
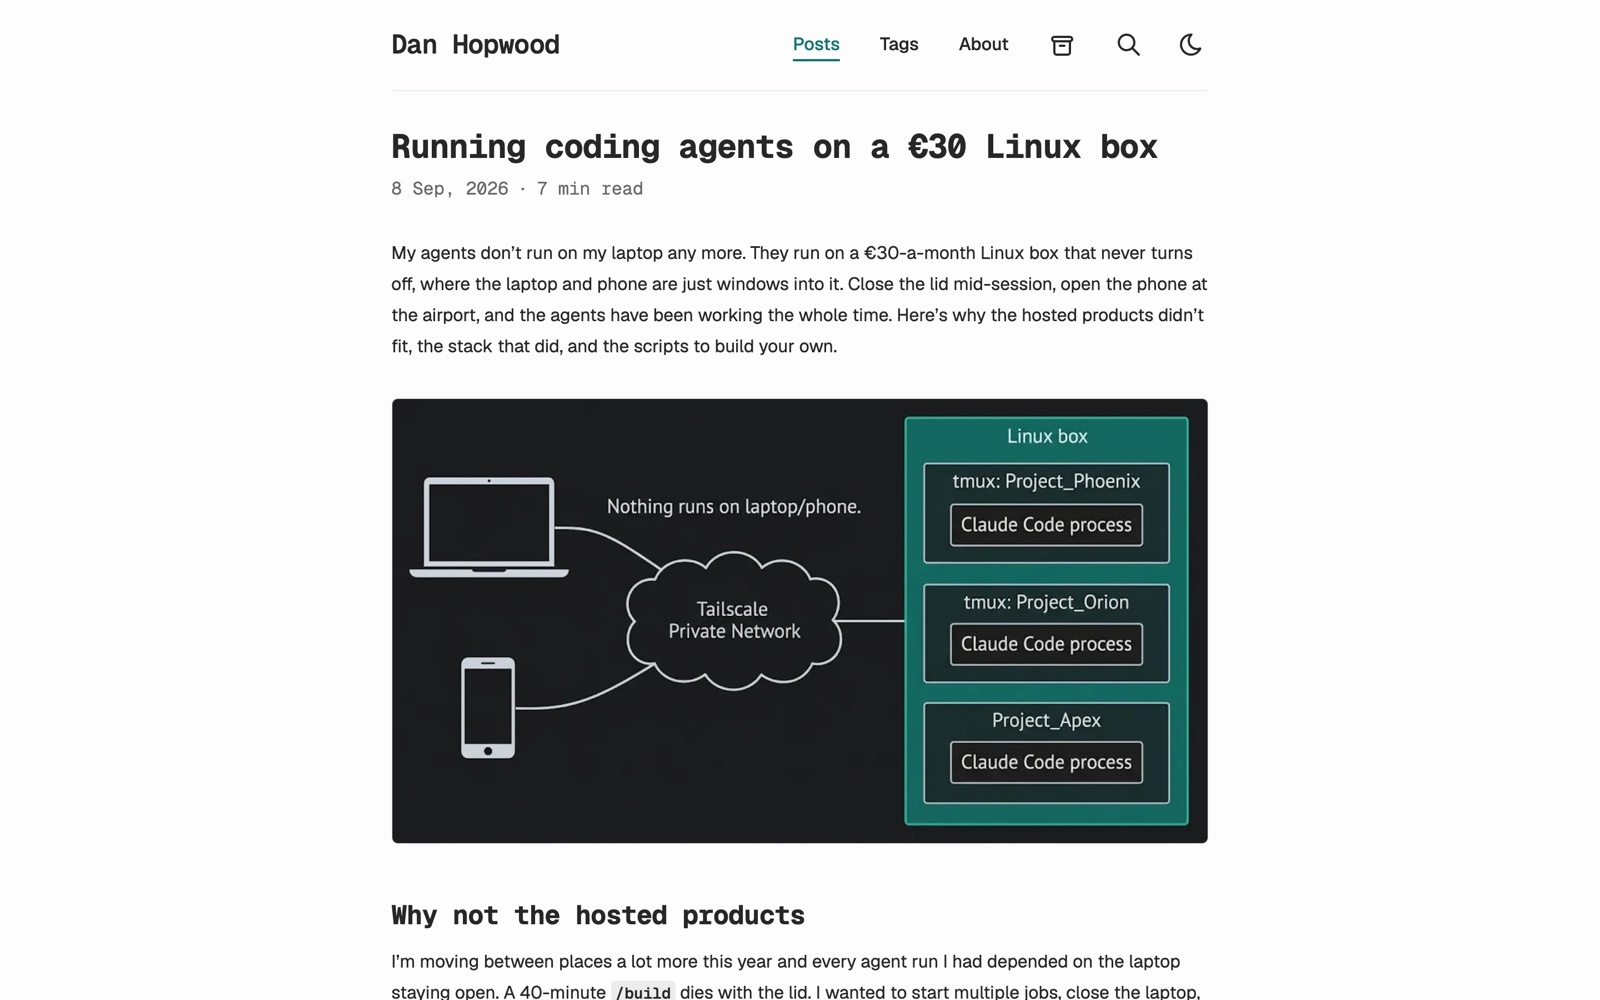
Его аргумент против облачных продуктов интересен тем, что он измерен, а не заявлен: по его наблюдению, каждый hosted-продукт (Claude Code в вебе, Codex cloud, Jules) привязывает сессию к одному GitHub-репозиторию и одному вендору. Для одного репозитория это нормально, но его работа требует 13 репозиториев, которые читают друг друга, и 16 MCP-серверов — ни один продукт такого не видит. Отсюда правило размеров, которое он вывел: одна сессия Claude Code — базовая нагрузка, каждая дополнительная добавляет около 200 МБ, плюс память под её MCP-серверы. 16 ГБ хватает, 32 ГБ — с запасом под браузер.
Сколько тянет железо
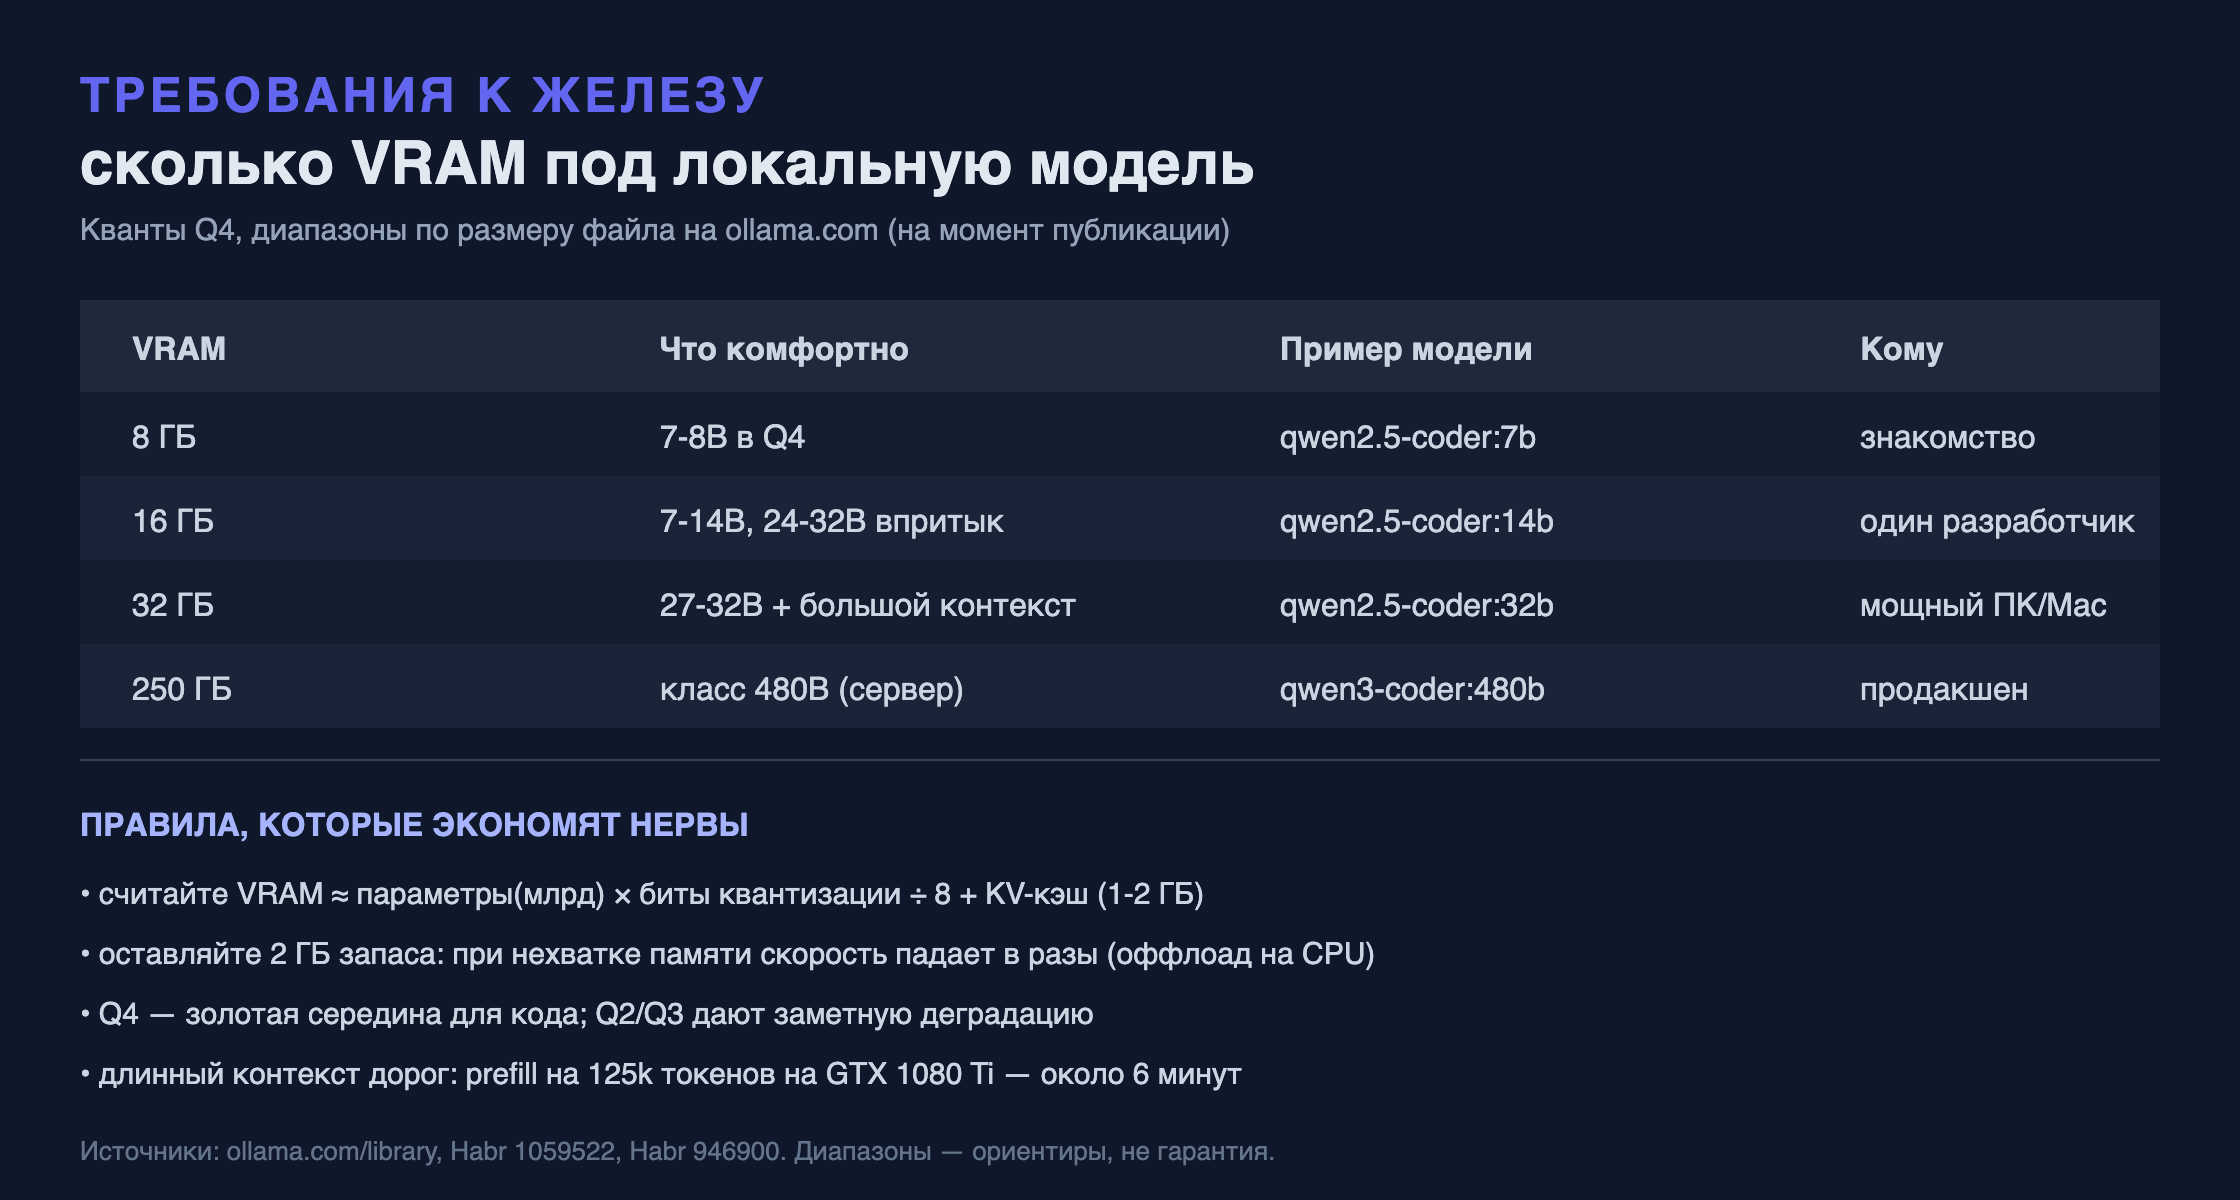
Главное ограничение локального запуска — VRAM. Если модель не помещается в видеопамять целиком, часть слоёв уходит в системную RAM и скорость падает в разы. Ориентиры по объёму из официальных карточек моделей на ollama.com и обзоров железа:
| VRAM | Что комфортно | Пример модели (Q4) |
|---|---|---|
| 8 ГБ | 7-8B | qwen2.5-coder:7b (4,7 ГБ) |
| 16 ГБ | 7-14B комфортно, 24-32B впритык | qwen2.5-coder:14b (9,0 ГБ) |
| 32 ГБ | 27-32B + большой контекст | qwen2.5-coder:32b (20 ГБ) |
| 250 ГБ | класс 480B (серверное железо) | qwen3-coder:480b (290 ГБ) |
Практические правила, которые стоит держать в голове:
- Счёт на глаз: VRAM ≈ параметры (в млрд) × биты квантизации ÷ 8 + KV-кэш. Под длинный контекст KV-кэш занимает ещё 1–2 ГБ сверху, и это часто забывают.
- Оставляйте запас. Рекомендация из обзоров железа — 2 ГБ свободной VRAM. При нехватке оффлоад на CPU обваливает скорость до однозначных токенов в секунду.
- Длинный контекст дорог. На GTX 1080 Ti prefill на 125 тысяч токенов занимал около 6 минут — то есть «залил весь репозиторий в контекст» на слабом железе превращается в ожидание.
Официальная карточка qwen3-coder:30b в Ollama подтверждает ограничение MoE-моделей: 30B всего, но лишь 3,3B активных параметров — она быстрая на потребительских GPU, тогда как 480B-версия требует «минимум 250 ГБ памяти».
Гибрид на практике
Самый рабочий вариант для большинства — не выбирать, а развести задачи. Логика такая:
- Локальная модель — для рутины: автодополнение, переименования, разбор незнакомого файла, генерация теста по существующей функции. Здесь приватность не страдает, а качество модели 7–14B достаточно.
- Облако — для сложного: архитектурные решения, незнакомая кодовая база, задачи, где важна frontier-модель. Сюда уходит только то, что не жалко отправить наружу.
- Код остаётся локально через git: облачный агент получает конкретную задачу, а не весь репозиторий.
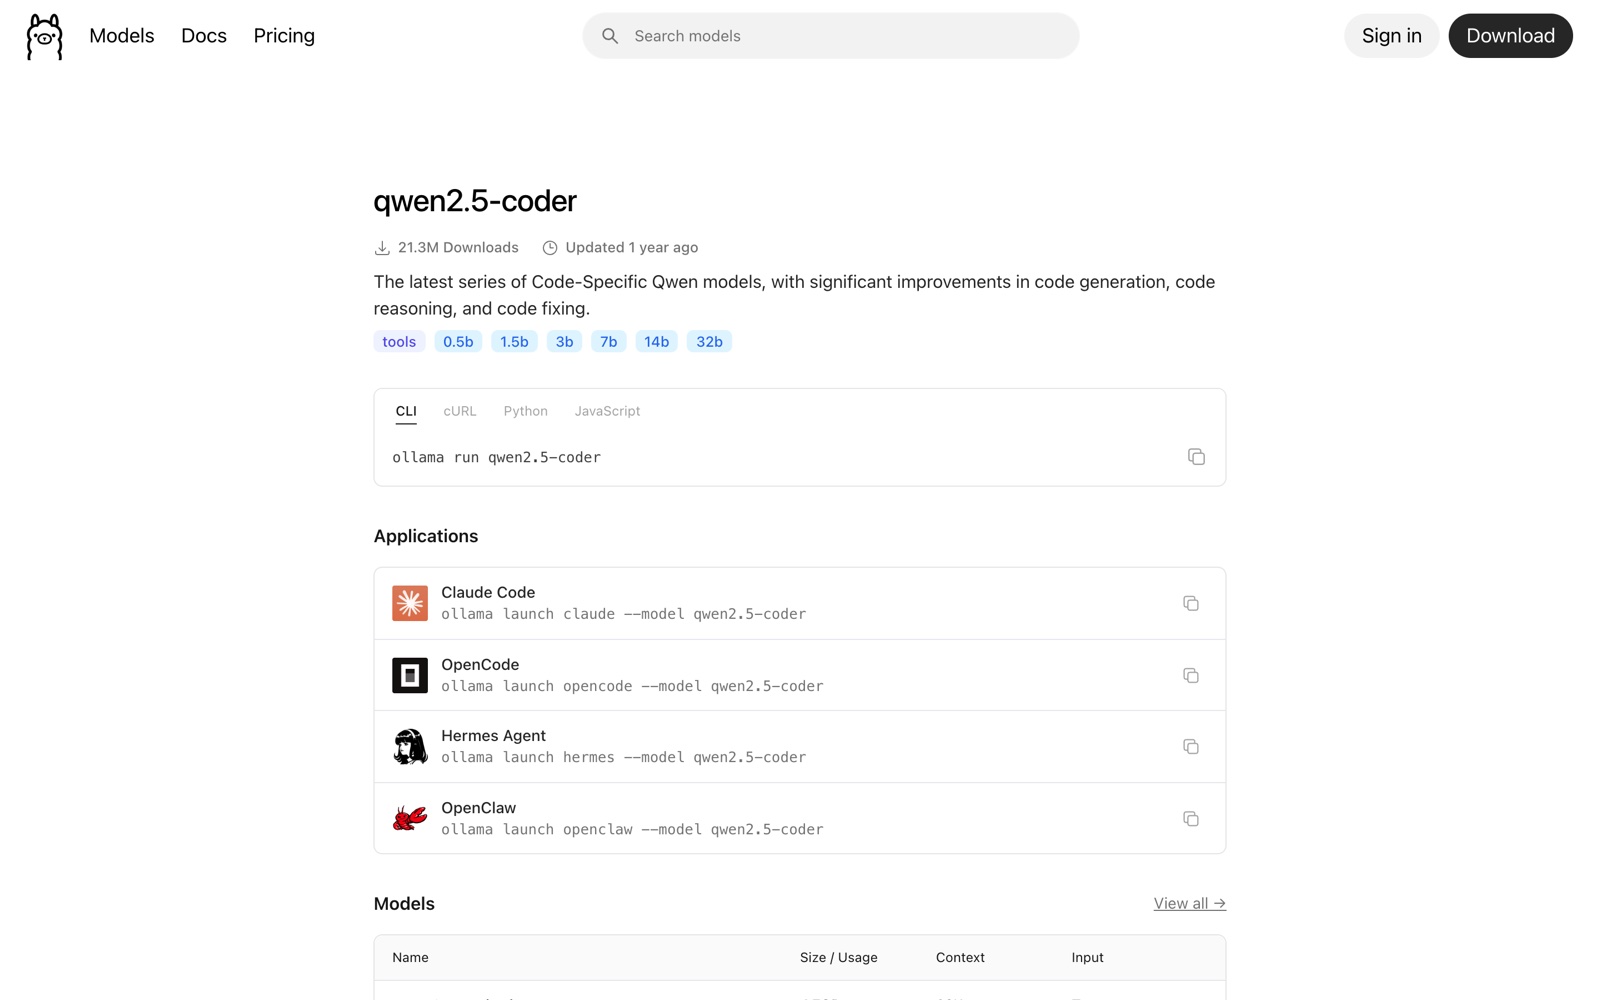
Типичная настройка локального стека через Ollama и запуск CLI-агента на нём:
# 1) ставим Ollama и тянем coder-модель под свой VRAM
ollama pull qwen2.5-coder:14b

# 2) проверяем, что модель отвечает и видит контекст
ollama run qwen2.5-coder:14b "напиши функцию на Python, которая проверяет ISBN-13"

# 3) локальный OpenAI-совместимый API живёт на порту 11434
#    (его же подхватывают LM Studio на 1234 и большинство CLI-агентов)
export OPENAI_BASE_URL="http://localhost:11434/v1"

# 4) агент с локальной моделью: все правки — на вашей машине
ollama launch opencode --model qwen2.5-coder:14b
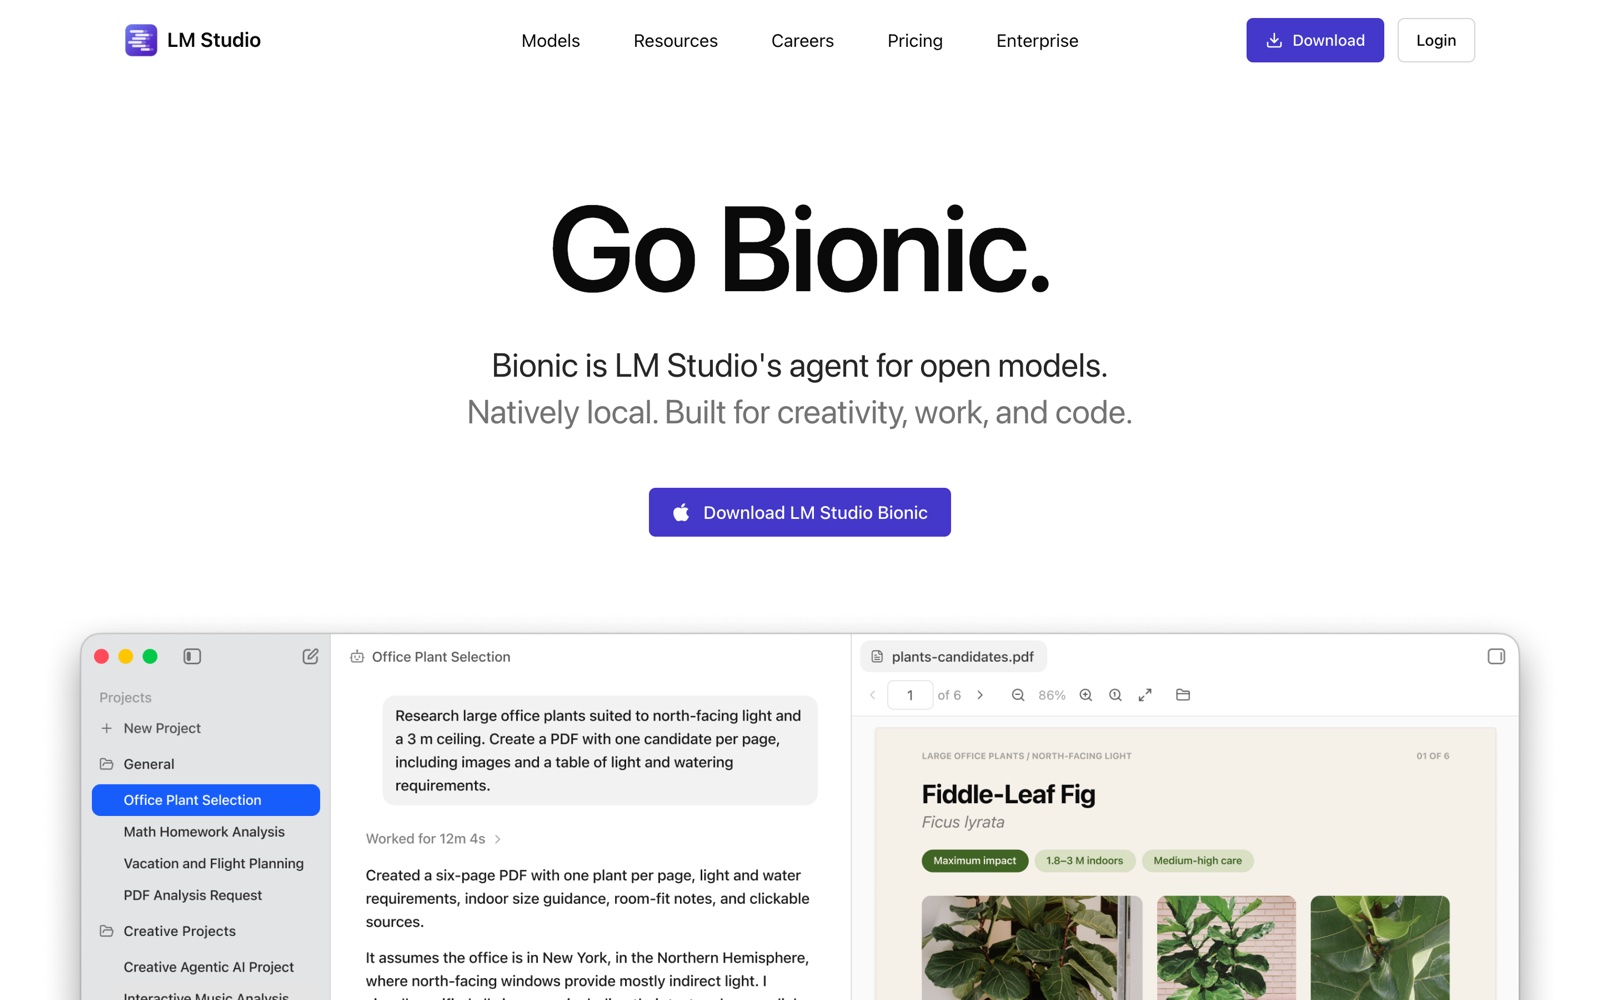
LM Studio решает ту же задачу через графический интерфейс: скачал модель, поднял локальный сервер, подключил к нему редактор. Для тех, кто не хочет возиться с терминалом, этот путь короче.
Как считать стоимость
Здесь важно не путать. Облако — это переменные расходы: подписка Claude Pro стоит $17–20 в месяц при оплате за год, Max — от $100, а API-тарификация считается за токены. Локальный запуск — расходы постоянные: железо и электричество.
Считаем честно, на примере. Допущения (не факт, а расчёт):
- готовая сборка с GPU на 16 ГБ — возьмём условные 150 000 ₽ в текущих ценах;
- срок службы — 4 года, то есть ~3 125 ₽/мес;
- потребление под нагрузкой — 250 Вт средних, 8 часов в день, тариф 6 ₽/кВт·ч → ~360 ₽/мес.
Итого локальный запуск обходится roughly 3 500 ₽/мес — без подписок, без валюты, без привязки к чужой карте. Для сравнения, облачная подписка Max — от $100 в месяц, что по курсу кратно больше, плюс регулярные сложности с оплатой из РФ. Важная оговорка: локальная модель класса 14B не равна frontier-модели по качеству, поэтому сравнивать «в лоб» цены нельзя — сравнивать нужно стоимость на решённую задачу приемлемого качества.
Российские реалии
Для многих локальный запуск — не про технику, а про независимость от зарубежных подписок и карт:
- Железо. GPU в РФ дороже и с ограничениями поставок. Для моделей до 14B часто достаточно уже имеющегося игрового ПК или Mac — тогда отдельные затраты вообще не возникают. Аккуратнее с б/у картами из майнинга: риск отвала памяти.
- Софт. Ollama, LM Studio, llama.cpp и сами веса моделей бесплатны и ставятся без VPN — оплачивать нечего.
- Оплата облака. Если облако всё же нужно, российские Visa и Mastercard не проходят: Stripe блокирует BIN, а дальше антифрод по гео-IP и требования 3D Secure. Рабочие варианты — посредники и зарубежные виртуальные карты, их сравнение есть в разборе «пять рабочих карт для оплаты подписок» на Klerk.
- Русскоязычные материалы. Полезны обзор железа под локальный ИИ на Habr — «Сколько нужно VRAM», практические заметки «Локальные LLM на слабом железе» и разбор подбора моделей «Локальные LLM: обзор и тестирование». С vc.ru пригодится гайд по LM Studio — там же отмечено, что при полностью локальном запуске подписка не нужна вовсе.
Ограничения
- Локальные модели не равны frontier. 7–32B модели закрывают автодополнение, рефакторинг и типовые задачи, но в «придумай неочевидное решение» заметно слабее. Если задача требует максимума качества, честнее признать, что облако выигрывает.
- VRAM не резиновая. Как только модель не влезает в память, скорость падает в разы, и работа локально становится больнее, чем платить за API.
- Агент не равно модель. Локальная модель при агенте с доступом в сеть не означает приватности: MCP-серверы и веб-поиск по-прежнему ходят наружу.
- Обслуживание — ваше. Обновления, драйверы, квантизация, память под контекст: облако не просит чинить CUDA после апдейта.
- Расчёт стоимости приблизителен. Цены на железо и электричество меняются, срок службы у всех разный — цифра выше показывает метод, а не точный результат.
- Размеры моделей актуальны на момент публикации. Ollama обновляет свои сборки, и «влезает/не влезает» может меняться от версии к версии.
Вывод
Выбор «локально или облако» — это ответ на два вопроса: готовы ли вы отправлять код наружу и готовы ли платить за это подпиской. Хотите приватность и не хотите зависеть от зарубежных карт — поднимайте Ollama или LM Studio и берите модель под свой VRAM, начиная с честной оценки доступной памяти. Нужен максимум качества — держите облако для сложного, а рутину отдайте локальной модели. Гибрид выигрывает у крайностей почти всегда: код остаётся у вас, а frontier-модель работает там, где она реально нужна.
Связанные статьи
- Локальные нейросети для кодинга: Qwen3-Coder и Ollama — установка и запуск
- GLM-5.3 open weight: запуск локально — что реально тянет железо
- Маленькие модели для кодинга — модели под слабое железо
- Claude Code через API — облачная оплата по токенам
- Песочницы для ИИ-агентов — изоляция запуска агента
Читайте также: Кейс: кодинг-агенты на Linux-коробке за €30: что реально тянет · Сколько стоит ИИ-агент в 2026: цены, подписки и оплата из России
