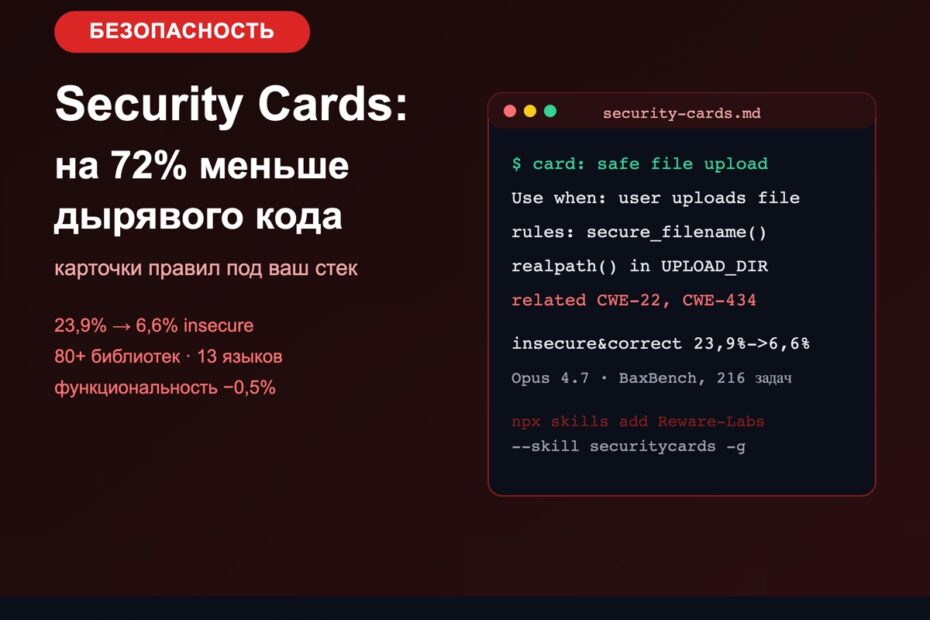
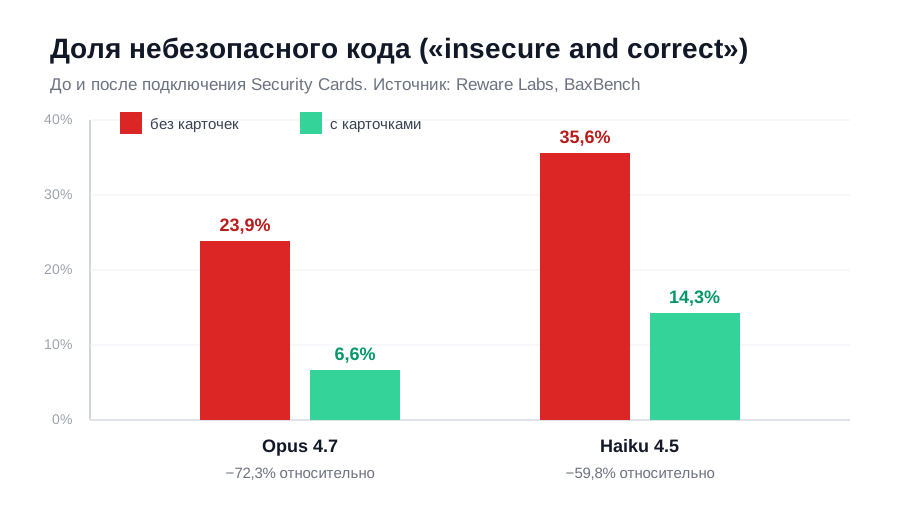
Кодинг-агент выдаёт код, который проходит тесты и запускается, но при этом несёт уязвимости: незакрытый path traversal в загрузке файлов, конкатенацию SQL, десериализацию недоверенного ввода. По данным из обзора Reware Labs, 40–50% образцов кода от моделей содержат как минимум одну дыру, а промпт «сделай безопасно» проблему не решает. Компания Reware Labs открыла набор Security Cards — карточек безопасности под конкретные библиотеки — и замерила эффект: доля небезопасного, но работающего кода упала с 23,9% до 6,6%. Это относительное снижение на 72,3%.
Проблема: агент пишет рабочий, но дырявый код
Люди делегируют агенту не только рутину, но и целые фичи: эндпоинты, обработку файлов, работу с базой. Модель при этом оптимизирует то, что её легко проверить — «код компилируется, тесты зелёные». Безопасность в эту проверку обычно не входит.
Reware Labs описывает причину так: большая часть провалов не в самой модели, а в framework- и library-specific деталях, которых у агента нет в контексте. Примеры из разных источников, на которые ссылается компания: неверная настройка сериализаторов, отсутствие лимитов на загрузку, дефолты фреймворков, которые в dev-режиме безопасны, а в проде открывают дверь.
Авторы подводят к неприятному выводу:
“you’re essentially paying premium token prices to generate vulnerable code nearly half the time you delegate tasks to an AI agent!” — Reware Labs, Introducing Security Cards
Перевод: «вы платите премиальную цену за токены, чтобы примерно в половине случаев получать от ИИ-агента уязвимый код». Это касается и агентов на моделях уровня Claude Opus, Fable и GPT Sol, а не только слабых моделей.
Что такое Security Cards
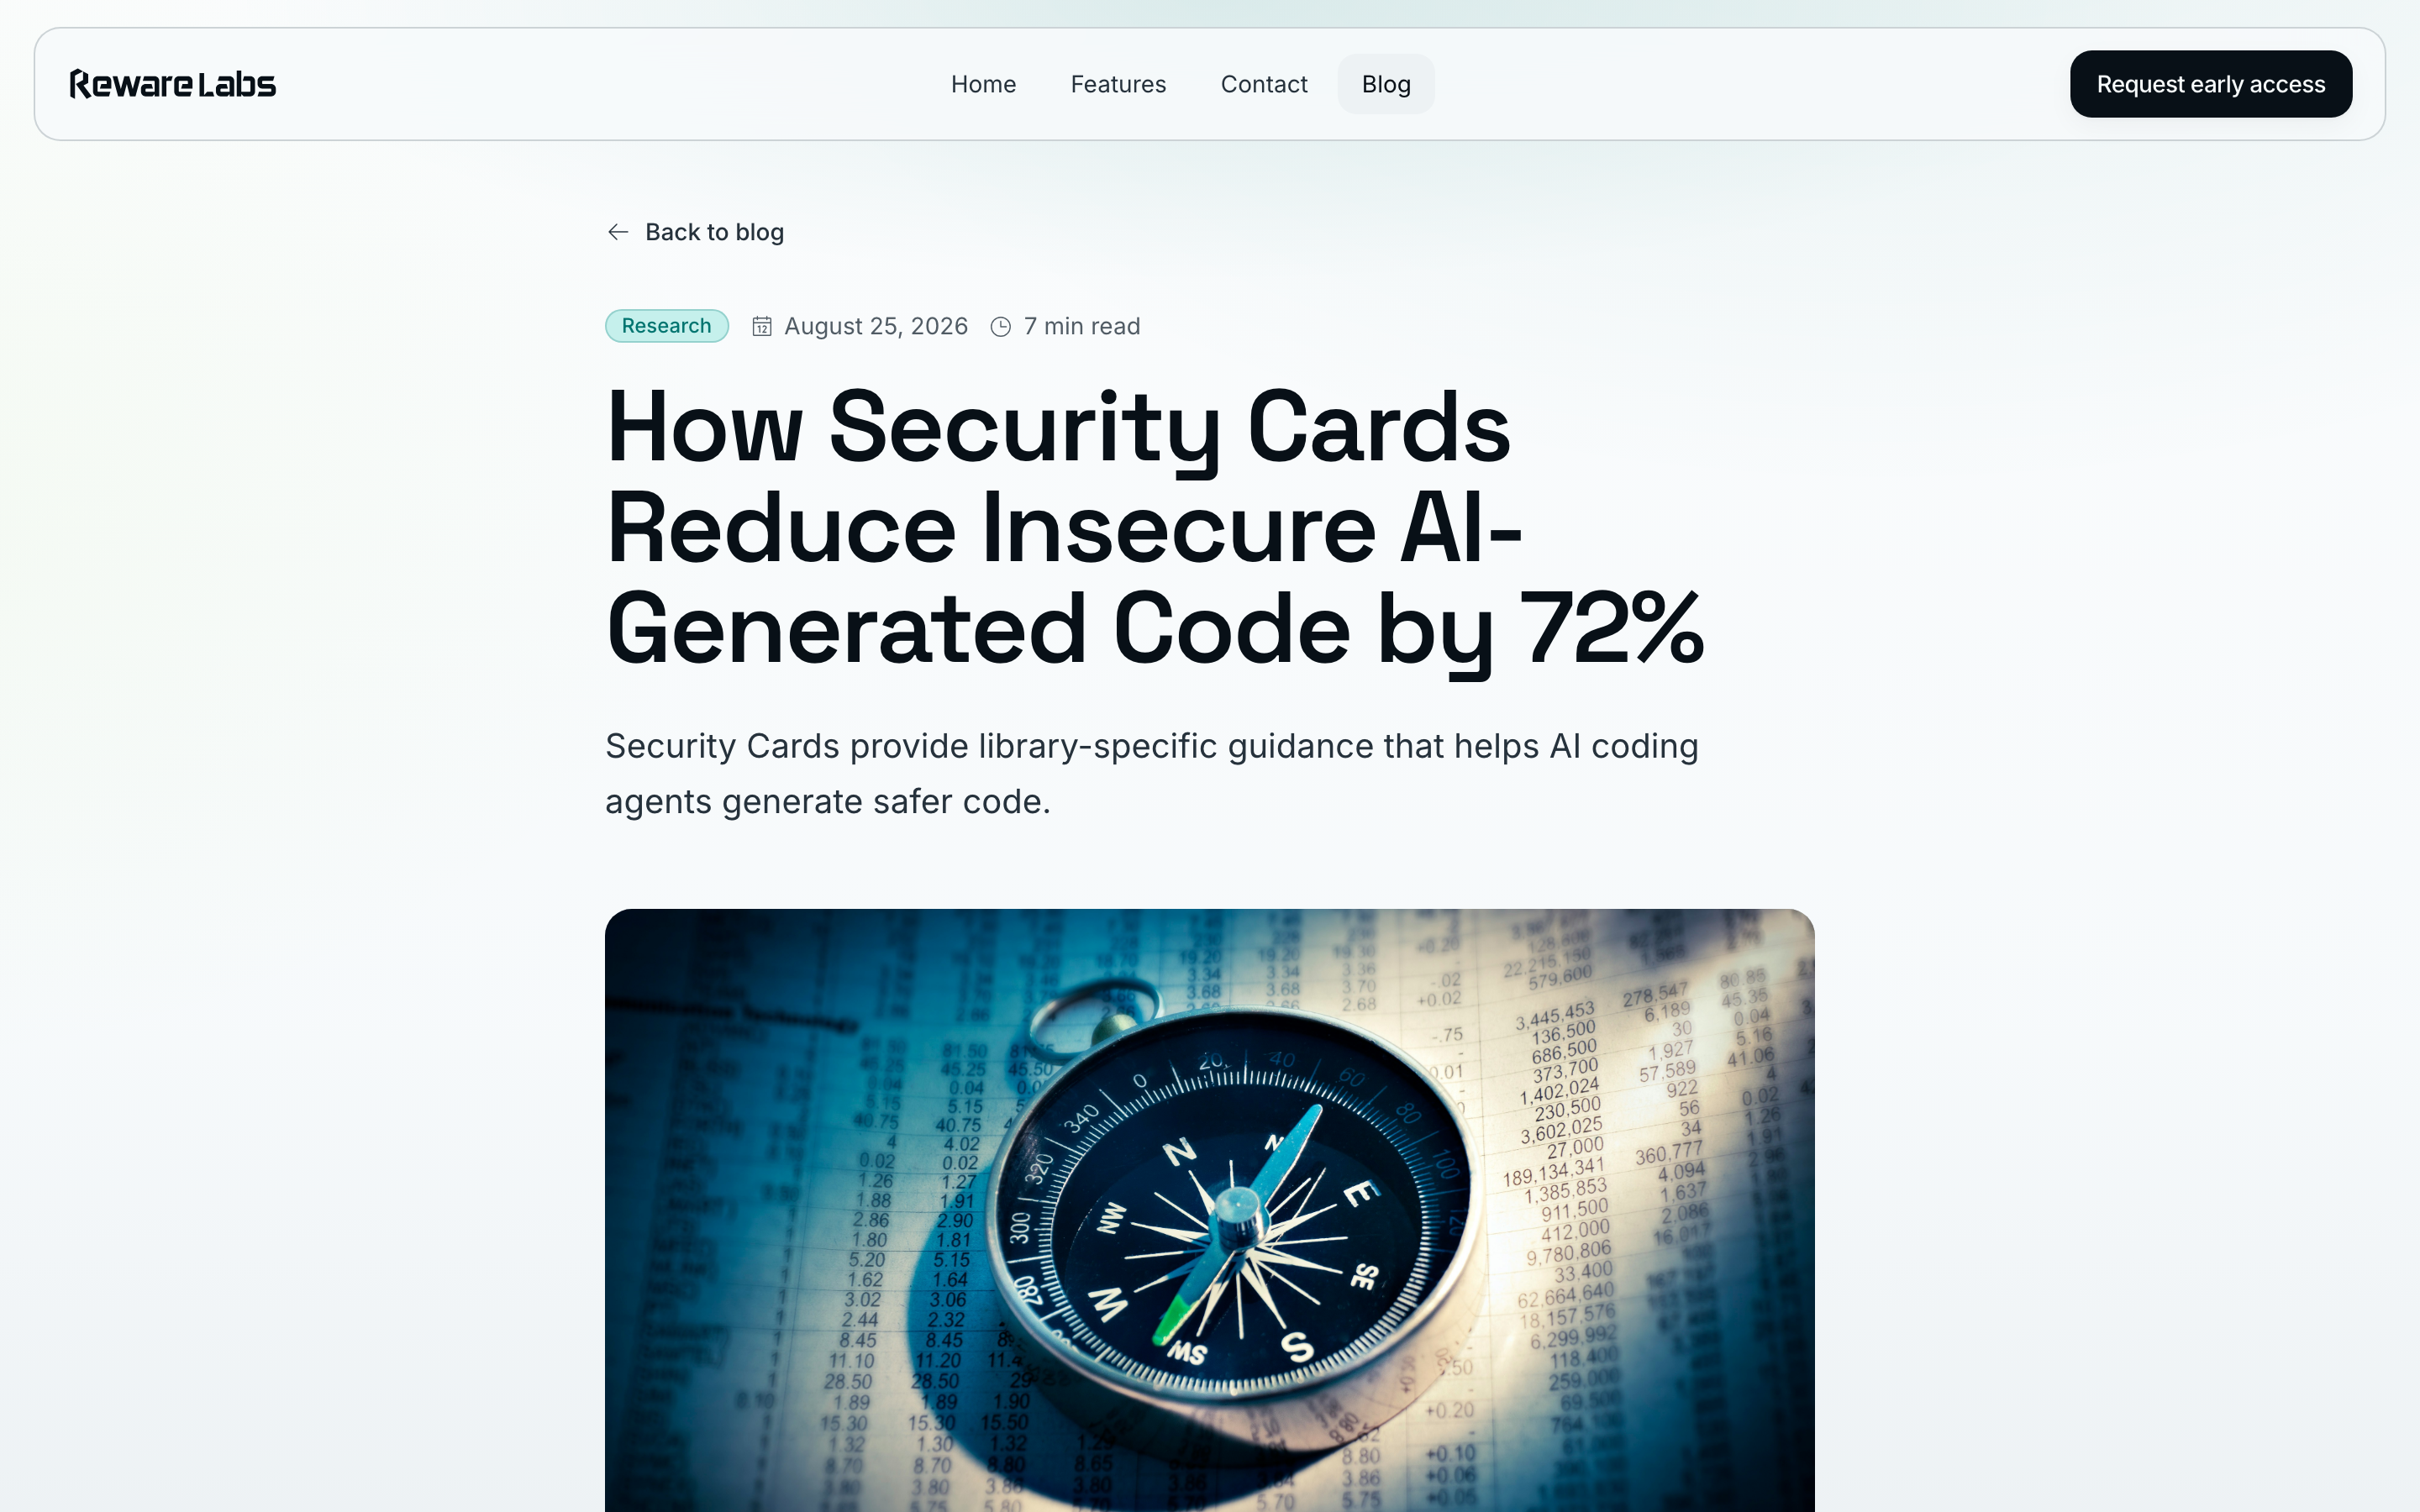
Security Card — это компактный документ, написанный так, чтобы его потреблял агент, а не человек. У карточки три части:
- «Use when» — сценарий, в котором карточка применима (например, «загрузка и скачивание файлов», «работа с JWT», «парсинг XML»).
- Правила — одно или несколько конкретных требований к коду, а не общие советы.
- Объяснения и короткие примеры кода, показывающие, как правило выглядит в жизни.
На момент публикации набор покрывает более 80 открытых библиотек на 13 языках. Для каждой библиотеки есть ещё Security Blueprint — сводка самых важных карточек на одну страницу: агент может сначала посмотреть blueprint, а деталку подтянуть по месту.
Ключевой момент механики: карточки не парсят ваш код. Скилл-обёртка нужна только чтобы агент нашёл релевантную карточку и подставил её как контекст при написании или ревью кода. В самой публикации Reware Labs это оговорено отдельно: скилл «не обращается, не использует и не передаёт ваш код» — он остаётся в том же окружении и у того же агента, что и раньше.
Дальше набор карточек открыт на GitHub (Reware-Labs/securitycards) и доступен для ручного просмотра на сайте securitycards.rewarelabs.com — там карточки сгруппированы по категориям внутри библиотеки.
Как замеряли снижение на 72%
Замер делали на BaxBench — бенчмарке для генерации бэкенд-приложений от исследователей ETH Zurich, LogicStar.ai, UC Berkeley и INSAIT. В BaxBench 392 задачи, 28 сценариев, 14 фреймворков и 6 языков; каждая задача — собрать работающее приложение по текстовому описанию и OpenAPI-спецификации, а проверяют его и на корректность (тесты), и на безопасность (end-to-end эксплуатация).
Оценка Security Cards шла на подмножестве из 216 задач (27 сценариев, 8 фреймворков, 4 языка), на двух моделях — Opus 4.7 и Haiku 4.5. Метрики:
- insecure and correct — доля корректных решений, которые всё равно валят хотя бы один тест безопасности. Главная метрика: она отсекает «код просто не работает» и показывает реальную дырявость.
- secure pass@1 — доля решений, которые и работают, и проходят все тесты безопасности с первой генерации.
- functional pass@1 — доля решений, проходящих все функциональные тесты.
| Метрика | Opus 4.7 без карточек | Opus 4.7 с карточками | Haiku 4.5 без карточек | Haiku 4.5 с карточками |
|---|---|---|---|---|
| insecure and correct | 23,9% | 6,6% (−72,3%) | 35,6% | 14,3% (−59,8%) |
| secure pass@1 | — | +21,4% относительно | — | +27,5% относительно |
| functional pass@1 | — | −0,5% относительно | — | −5,0% относительно |
Цифра «−72%» — это относительное снижение для самой точной на тот момент модели Opus 4.7. На младшей Haiku 4.5 эффект тоже большой, но меньше (59,8%): похоже, модели послабее хуже следуют карточкам. Важнее второе: просадка по функциональности почти нулевая у Opus (−0,5%) и умеренная у Haiku (−5,0%). То есть карточки не подменяют работоспособность на безопасность, а добавляют безопасность поверх.
Как собрать карточки под свой стек
У Reware Labs карточки извлекают полуавтоматически: гибрид детерминированных и AI-процессов вытаскивает разбросанное по репозиториям знание (документация, исходники, тесты, конфиги), прогоняет через несколько слоёв автопроверки и человеческое ревью. Авторы утверждают, что после итераций доля карточек, требующих ручной правки, упала ниже 10%. Домашний процесс проще — упор на свой стек:
- Возьмите официальные ориентиры как каркас. OWASP Top 10 (owasp.org/Top10) — категории веб-уязвимостей, OWASP ASVS — проверяемые требования, CWE Top 25 — самые опасные типы слабостей по частоте и последствиям. Карточка должна указывать на конкретный CWE, который она закрывает.
- Пройдитесь по своим зависимостям. Не по всем 80 библиотекам, а по тем, что реально в проекте: веб-фреймворк, ORM, сериализатор, парсеры, крипто.
- На каждый риск — правило с примером. Не «валидируй вход», а «используй
secure_filename()и проверяй итоговый путь внутри базовой папки». - Кладите карточки в правила проекта. Файл конвенций вроде
AGENTS.md— естественное место; как его устроить, разобрано в статье AGENTS.md — файл конвенций для агента.
Пример карточки (наш, в формате Reware Labs, для наглядности) на path traversal при загрузке файлов:
# Card: Safe file upload (Python / Flask)
Use when: приложение принимает файлы от пользователя и сохраняет их на диск.

Rules:
- Никогда не используй имя файла от клиента как путь на диске.
- Пропускай имя через werkzeug.utils.secure_filename().
- Храни файлы вне web-root; отдавай их через контроллер, а не статикой.
- Проверяй итоговый путь: os.path.realpath(path) должен начинаться с UPLOAD_DIR.

Related CWE: CWE-22 (Path Traversal), CWE-434 (Unrestricted Upload)
Для агента такая карточка — это не совет, а проверяемое условие: он видит конкретную функцию, конкретное имя и конкретную проверку. Именно этим «карточка» отличается от расплывчатой инструкции «пиши безопасный код», которую агент игнорирует, если она мешает пройти тесты.
Что метод не закрывает
Карточки — про библиотечные дефекты. Логические ошибки они не ловят:
- авторизация как бизнес-логика. «Пользователь A не должен видеть заказы пользователя B» — это правило вашей модели данных, а не библиотеки; карточка не подскажет, где забыли проверку владельца.
- ошибки в проектировании протоколов и кастомной криптографии: карточка на JWT не спасёт самописную схему подписи.
- цепочки из нескольких сервисов, где дыра возникает на стыке, а не внутри одной библиотеки.
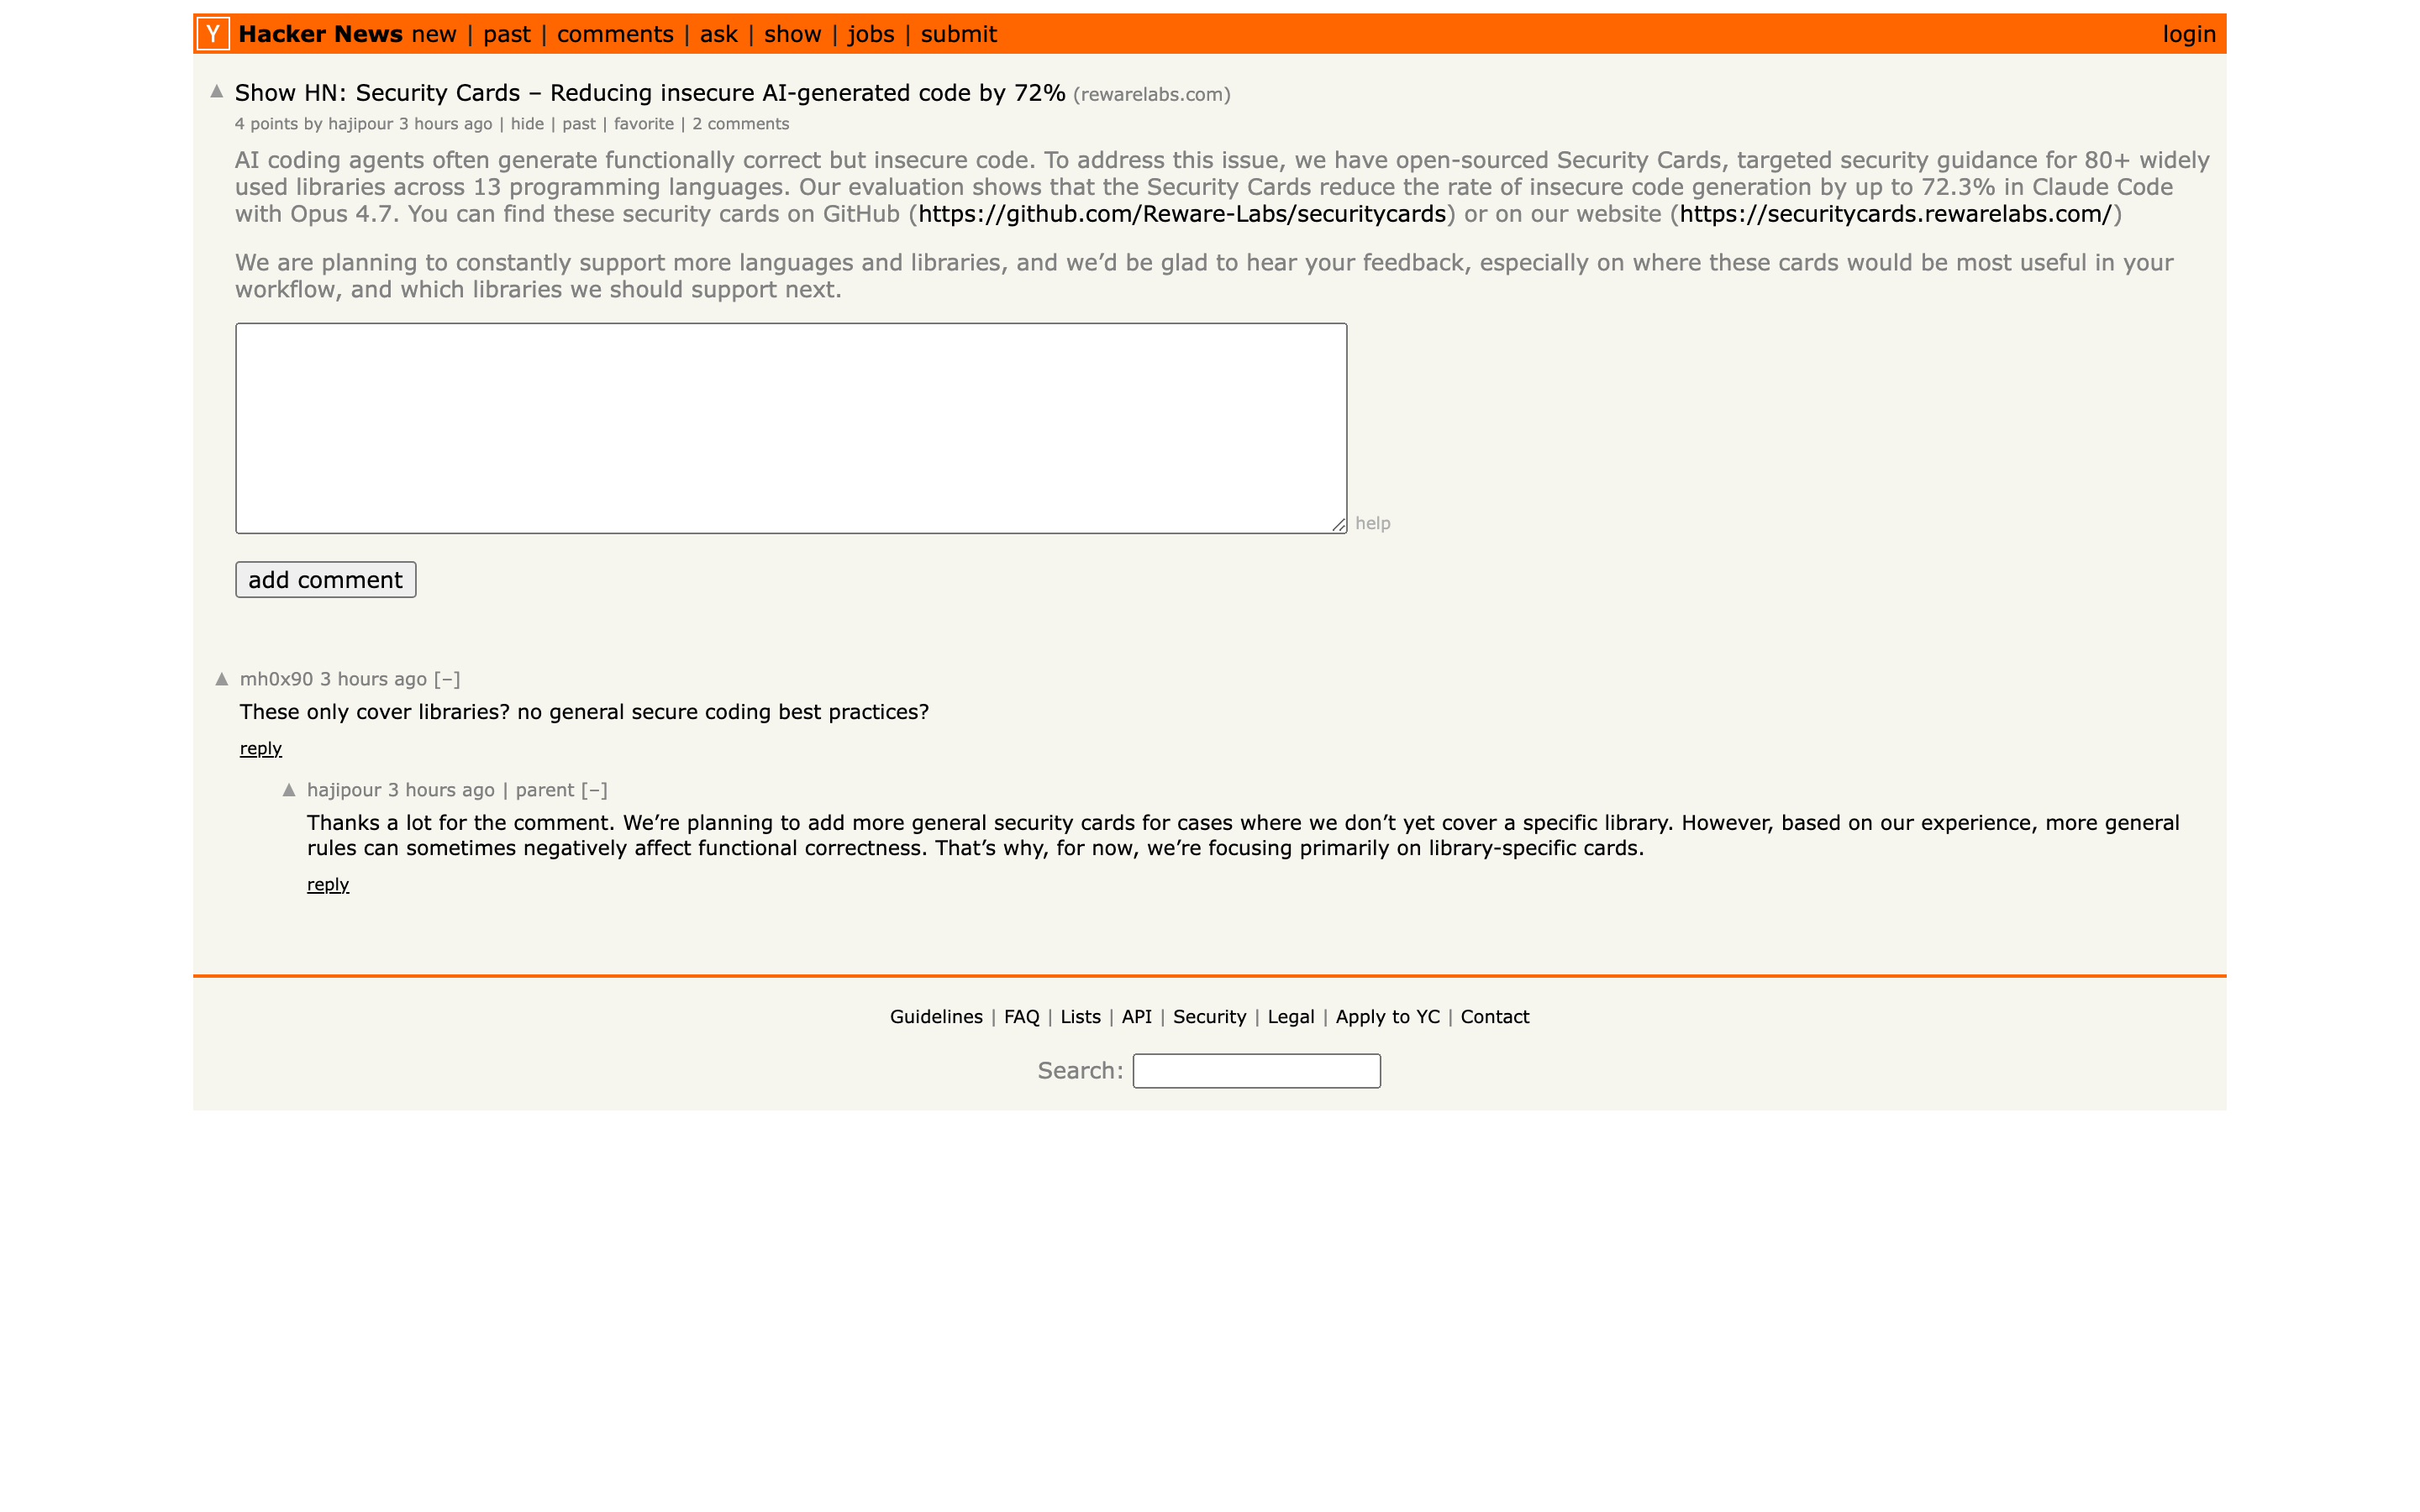
Именно поэтому в HN-треде к анонсу первый комментарий был прямой: покрывают ли карточки «только библиотеки» или и общие практики безопасного кодирования. Ответ автора:
“We’re planning to add more general security cards… However, based on our experience, more general rules can sometimes negatively affect functional correctness.” — hajipour, HN
Перевод: «мы планируем добавить и общие карточки, но по нашему опыту общие правила иногда негативно влияют на функциональную корректность». Честная позиция: слишком абстрактное правило заставляет агента придумывать, где его применить, и ломает рабочий код.
Как встроить в процесс
Карточки не отменяют ревью и сканеры — они работают до них.
- Генерация. Карточка в правилах проекта сужает пространство, в котором агент пишет код. Это самая дешёвая точка: пусть «правильно» будет вариантом по умолчанию.
- Ревью. Отдельной командой («review this code using the Security Cards skill») карточки превращаются в чек-лист для ревьюера-агента.
- SAST и тесты. Динамические сканеры и тесты безопасности ловят то, что карточка пропустила, особенно логику. О том, как поручать агенту тесты, есть разбор ИИ-агент для тестирования: чистка тестов и ИИ-тесты на pytest и Playwright.
- Специфика агентов. Сама по себе генерация безопаснее не делает агента безопасным: у него есть доступ к файлам, git и сети. Общий разбор — в статье Безопасность ИИ-агентов, про внедрение инструкций через контент — Промпт-инъекции в кодинг-агентах.
Российские реалии
- Установка. Скилл ставится командой
npx skills add Reware-Labs/securitycards --skill securitycards -g; сам набор карточек лежит на GitHub. GitHub и npm из России доступны без VPN, скачивание открытых файлов проблем не вызывает. - Сам агент. Чтобы карточками пользовался Claude Code, Codex или Cursor, нужен рабочий аккаунт у зарубежного провайдера. Вход и оплата из РФ ограничены: российские Visa/Mastercard не принимаются, часто нужен VPN. Варианты оплаты и риски разобраны в русскоязычных материалах, например у PVS-Studio на Habr.
- Свой процесс под регуляторку. Внутренние стандарты безопасной разработки и требования аудита задают, что и как проверять; карточки ложатся в этот процесс как формализованные правила для агента, но юридических выводов они не заменяют.
- Русскоязычная фактура. Тема деградации безопасности при генерации кода разобрана на Habr в изложении исследования IEEE-ISTAS 2025 — «Деградация безопасности при итеративной генерации кода с помощью ИИ»; таксономия угроз для агентов — «Top 10 угроз для Agentic AI».
Ограничения
- Замер узкий. 72,3% получены на одной связке (Claude Code + Opus 4.7) и на подмножестве BaxBench из 216 задач. Переносить цифру на другой агент или на ваш реальный проект напрямую нельзя — это оценка на бенчмарке, а не аудит вашего кода.
- Разброс по моделям. На Haiku 4.5 эффект заметно слабее (59,8%) и функциональная просадка больше (−5,0%). Слабая модель хуже следует карточкам.
- Покрытие библиотеками. Набор — 80+ библиотек; если ваша зависимость не в списке, карточки на неё нет. Общие карточки авторы только обещают.
- Метрика «insecure and correct» узкая по смыслу. Она считает только решения, прошедшие функциональные тесты, и только те безопасностные проверки, что есть в BaxBench.
- Логику метод не закрывает. Авторизация, бизнес-правила и кастомные протоколы остаются на ревью и тестах.
- Версии. Описанное состояние карточек и результаты — на момент публикации, 10.09.2026; набор активно расширяется, цифры могут измениться.
Связанные статьи
- Безопасность ИИ-агентов — что агент может испортить помимо кода
- Промпт-инъекции в кодинг-агентах — как через контент управляют агентом
- AGENTS.md — файл конвенций для агента — куда класть правила проекта
- ИИ-тесты на pytest и Playwright — проверки, которые карточка не заменяет
Читайте также: Кейс: Google о prompt injection против кодинг-агентов: от промптов к автономии · Настройка ИИ-агента под свой проект: чек-лист из 10 шагов
