Автор блога Digital Thoughts (Pawel Jozefiak, thoughts.jock.pl) называет себя человеком Anthropic: его агент целиком работает на моделях Claude, а Fable 5 в июне стал его дефолтом. И всё же 9 сентября 2026 года он написал пост «I Am an Anthropic Guy. GPT-6 Astra Made Me Resubscribe to Codex» — вернул подписку Codex Pro, которую до этого отменял, и признался, что впервые за год сменил основной инструмент. Ниже — перевод и разбор его опыта: что стало лучше, что хуже, на чём сломался переход и как проверить смену агента на своём проекте за день.
Что было и что стало
Логика автора — не «вышла новая модель», а «изменилось, за что я плачу и чем пользуюсь». До этого он жил на лестнице Anthropic: Haiku для быстрого и дешёвого, Sonnet как рабочий дефолт, Opus для тяжёлых задач. За год лестница переехала:
“Haiku stopped being relevant to me a long time ago […] Sonnet I use for nothing, not even research, which I did not expect to say about a model I ran daily last year. Opus 5 is fine-ish. Fable sits far enough past the rest that most of the time the answer is just Fable.” — Digital Thoughts
Перевод: «Haiku давно перестал быть для меня релевантен. Sonnet я не использую ни для чего, даже для research — не ожидал, что скажу это о модели, которой год назад пользовался каждый день. Opus 5 так себе. Fable настолько опережает остальных, что чаще всего ответ — просто Fable». Он же отметил курьёз: страница документации Anthropic рекомендует начинать с Opus 5, а справка Claude Code по-прежнему называет дефолтом Sonnet — обе живы одновременно.
Сравнение смены по ключевым осям:
| Задача | Claude Code (Fable 5.1) | Codex (GPT-6 Astra) |
|---|---|---|
| Аудит архитектуры своего агента | Нашёл 85 проблем в прошлый прогон | Нашёл заметно больше, включая то, что Fable не увидел |
| Работа через браузер | Последнее средство: медленно, дорого по токенам | Готов принять браузер как дефолт |
| Дизайн интерфейса | Побеждает: «взял и сделал так, что сравнивать уже нечего» | Работает приемлемо, но «второй» после Fable |
| Стоимость задачи | На высоком режиме ест заметно больше токенов | То же качество меньшим числом токенов |
| Лимиты подписки | На Max Fable ограничен 50% недельного лимита; на Pro вне плана | Пятичасовое окно + недельный лимит, оценивается в 100–900 сообщений на Pro 20x |
Три вещи, которые оказались лучше
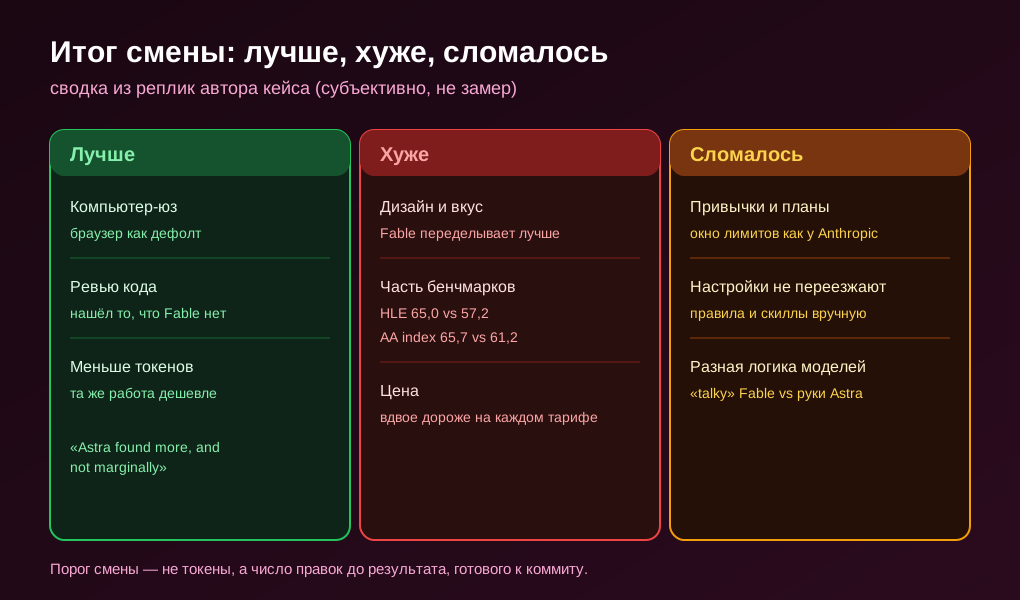
1. Компьютер-юз без оговорок. Раньше у автора было правило: не давать модели управлять браузером, если есть программный путь (API, CLI, MCP). Браузер — потому что медленно, хрупко и жрёт токены на разглядывание страниц. С Astra он готов принять браузер по умолчанию, и это важнее, чем звучит: пропадает целый слой — думать про токены, схемы API, существующие MCP. По данным, которые он приводит, на OSWorld Astra даёт 72,6% при ~40 минутах на задачу против 65,7% при ~75 минутах у предшественника, а на ScreenSpot-Pro — 92,7%.
2. Находит больше в ревью. Автор прогнал оба агента по одному и тому же материалу — своему агенту, его скиллам, реестрам ошибок. «Astra found more, and not marginally. It saw things Fable did not see, in a codebase Fable helped build». Оговорка самого автора: это не бенчмарк, а качественный прогон, где результат — список тихих проблем, а не оценка. Свой чек-лист он оформил в Agent Architecture Audit Kit и считает прогон двумя фронтир-моделями самым дешёвым сигналом качества из известных.
3. Меньше токенов на ту же работу. Fable 5.1 автор описывает словом «talky»: по замерам разных людей модель жжёт на 25–50% больше токенов, чем Fable 5 на тех же задачах, а один замер дал трёхкратный рост. Simon Willison, по его словам, зафиксировал 2 000 выходных токенов на medium и 65 927 токенов при $3,30 на max. Astra при том же режиме обходится меньшим числом токенов — и это половина запаса по лимитам, вторая половина — сам план.
Две вещи, которые оказались хуже
Дизайн. Автор дал Astra сделать дизайн-работу — результат приемлемый. Потом попросил Fable переделать: «Fable nailed it, in the way where you stop comparing and just use the second one». Механизм он не берётся объяснять, но подчёркивает разницу осей: вкус и «способность» — разные вещи, и опыта в дизайне у агента OpenAI меньше. Dan Shipper, которого автор цитирует, назвал Astra «show horse», который добавляет nav-бары и маркетинговые тексты в приложения, где надо проще.
Отдельные фронтир-бенчмарки. Тут важно не поверить заголовкам. По данным автора, Fable 5.1 обходит Astra на Humanity’s Last Exam (65,0 против 57,2) и выше по индексу Artificial Analysis (65,7 против 61,2), а Opus 5 выигрывает у обоих в индексе для кодинг-агентов. Процитированный всеми результат ARC-AGI-3 в 99,9% получен на кастомном обвязке; на дефолтной та же модель даёт 62,7% и стоит дороже. SWE-bench Verified для Astra, по его словам, вообще не публиковался. Вывод автора: усреднённые тесты под модель предыдущего поколения не измеряют то, что реально изменилось, — способность держать работу с компьютером часами.
Что сломалось при переходе
Автор честно перечисляет точки трения, а не только победы:
- Привычки и промпты. Его прежняя оценка «у OpenAI нет пятичасового окна» оказалась наполовину неверной: в Codex есть и пятичасовое окно, и недельный лимит сверху, как у Anthropic. Часть привычек и планирования пришлось переделывать под новую структуру лимитов.
- Ритуал «отменял-переподписывался». По его словам, это уже шутка в его собственных заметках — он отменял и возвращал подписку Codex не в первый раз, что говорит о стоимости такого перехода: контекст и настройки не переезжают сами.
- Разная логика моделей. Fable 5.1 сделали лаконичнее по тексту, но «проактивнее» по действиям: она сама берёт инициативу, и это не всегда на пользу. Astra, наоборот, пришлось принять как более «работающую руками» модель. Ни одна не заменяет другую один в один.
- Совместимость настроек. Настройки Claude Code (правила, скиллы, хуки) не переносятся в Codex напрямую; переносить приходится вручную, и про то, как живут правила проекта, — в статье AGENTS.md — файл конвенций.
Как проверить смену агента на своём проекте
Чужие впечатления не заменяют прогон на своей работе. Автор доверяет только одному тесту — направить агента на свою систему и сравнить с другой моделью на том же материале. Шаблон на день, повторяющий его подход:
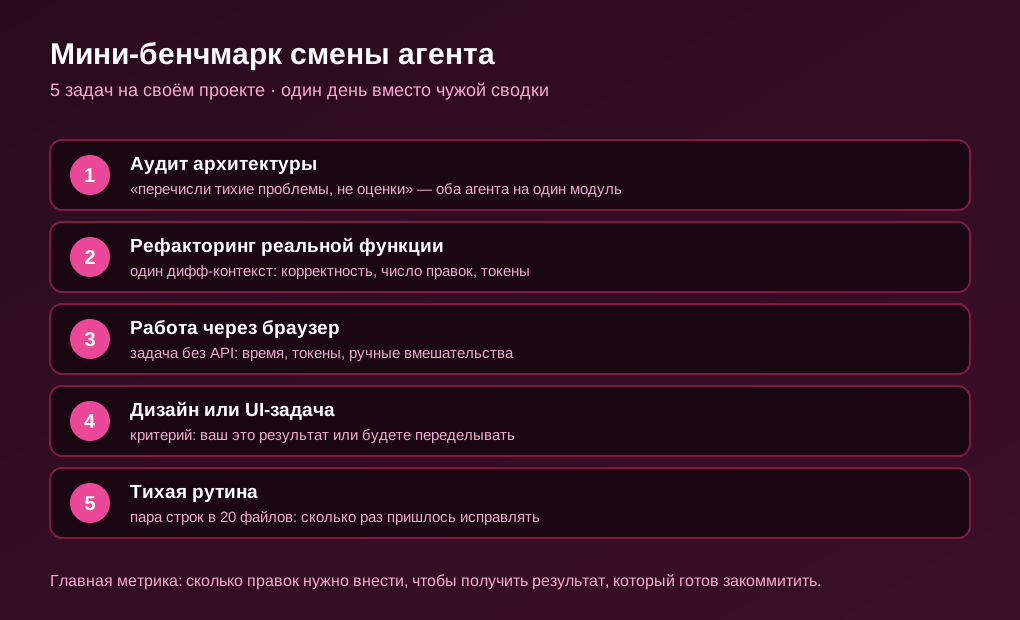
Мини-бенчмарк смены агента (5 задач, ~1 день)

1. Ревью архитектуры
   Дать оба агента на один модуль: "перечисли тихие проблемы, не оценки".
   Сравнить: что нашёл один и не нашёл другой.

2. Рефакторинг реальной функции
   Одна и та же задача, один и тот же дифф-контекст.
   Мерить: корректность, число правок, расход токенов.

3. Работа через браузер или внешний сервис
   Задача с формой/UI, где нет API.
   Мерить: время, токены, число ручных вмешательств.

4. Дизайн или UI-задача
   Критерий один: ваш ли это результат, или будете переделывать.

5. Тихая рутина (пару строк в 20 файлов)
   То, что вы делаете каждый день.
   Мерить: сколько раз пришлось исправлять.
Метрика, которую сам автор считает главной: не потраченные токены и не цена, а сколько раз вы правите модель, чтобы получить то, что готовы закоммитить. Если правите постоянно — автоматизации не случилось, просто переехала клавиатура.
Когда менять агент не надо
- Если у вас один стек и он вас устраивает. Смена модели — это переезд настроек, промптов и правил. Если текущий агент попадает в задачу с первых правок, экономия не окупит переезд.
- Если задача не про то, где новый агент силён. Выигрыш автора в агенте-аудите и компьютер-юзе; на дизайне он остался на Fable. Проверяйте на своём типе задач, а не на «средней».
- Если решает вкус, а не способность. Инструмент, который «понимает, как должно выглядеть», описанных чартов не имеет.
- Если нет запаса по бюджету и лимитам. Astra стоит ровно вдвое дороже предшественника на каждом тарифе, по данным автора; подписка — не бесплатный переход.
Российские реалии
- Оплата обеих подписок. Российские Visa/Mastercard не принимают: почти все ИИ-сервисы биллятся через Stripe, который отклоняет карты российских банков по BIN, а Россия отсутствует в списке поддерживаемых стран Anthropic. Рабочие схемы с ценой каждой разобраны на vc.ru.
- Лимиты и блокировки. В мае 2026 Anthropic массово блокировала аккаунты из РФ; потеря кода и истории чатов не компенсируется, разбор последствий — у Selectel. Оплата подписки из РФ и риски — в материале Habr / Exnode.
- VPN и смена региона. Стабильный «чистый» IP из поддерживаемой страны важнее самого VPN; регион после регистрации не меняют, платежи не дробят. Совет из комментариев на Habr — держать запасной инструмент (Codex/GPT) и бэкапить промпты и проекты в своей инфраструктуре: «меня забанили в Claude Code на аккаунте за $200».
- Миграция контекста. Настройки и правила агента не переезжают между Claude Code и Codex автоматически; их переносят вручную, что в кейсе автора и было одной из точек трения.
Ограничения
- Это субъективный опыт, а не замер. Автор прямо пишет «I did not benchmark it» и сравнивает прогоны на своём материале. Все сравнения «лучше/хуже» — его впечатления, их нельзя переносить как числа.
- Числа из источника, а не проверенные независимо. 72,6% на OSWorld, 65,0 против 57,2 на Humanity’s Last Exam, цены и токены Simon Willison — это то, что приводит автор; перед публикацией их стоит сверять по первоисточникам провайдеров.
- Лимиты и цены меняются. «100–900 сообщений на Pro 20x», «Fable вне плана на Pro», цена подписок — состояние на 09.09.2026. Провайдеры правят это регулярно.
- Тренд на блокировки сохраняется. Отдельного российского разбора этого кейса нет; выводы о доступности инструментов из РФ строятся по событиям 2026 года и могут устареть.
- Один кейс — не правило. То, что Astra обогнал Fable на аудите конкретного агента, не значит, что он обгонит на вашем стеке.
Связанные статьи
- GPT-6 Astra: что известно — разбор модели OpenAI
- Claude Fable 5.1: новая модель — что принесла версия 5.1
- Модели для кодинга 2026 — обзор моделей и их нишей
- Claude Code vs Cursor vs ZCode — сравнение агентов
Читайте также: Claude Code vs Codex: что выбрать в сентябре 2026 · Кейс: Claude Code, Codex и Pi на SWE-Bench Pro: одна точность, двойная цена
