Обычный текст программа распознаёт построчно, слева направо, а вот с формулами на снимке этот подход не работает: дробь, индекс или корень существуют в двумерном пространстве, где расположение символов друг относительно друга не менее важно, чем сами символы. Именно поэтому математические записи распознаются сложнее текста — классический OCR путает знаки, теряет вложенность и превращает аккуратное уравнение в бессмысленный набор символов. В статье разберём, почему так происходит и как современные нейросети постепенно решают эту задачу.
Чем формула отличается от обычного текста
Когда мы говорим о распознавании текста, речь почти всегда идёт об одной и той же задаче: превратить последовательность букв в машиночитаемую строку. Слова идут друг за другом, строки — друг под другом, и алфавит конечен. Формула устроена принципиально иначе — и именно в этом различии кроется корень всех сложностей.
Обычный текст — это одномерный поток символов. Читать его можно строго слева направо (или справа налево, в зависимости от языка), и порядок символов однозначно определяет смысл. Программе достаточно «нарезать» строку на отдельные буквы, распознать каждую и склеить результат обратно — примерно так работают классические системы оптического распознавания символов.
Математическая запись живёт по другим правилам. Числитель дроби расположен над знаменателем, показатель степени — выше и правее основания, индекс — ниже, а предел суммы — под символом сигмы. Здесь важна не только последовательность знаков, но и их взаимное расположение на плоскости: смещение на несколько пикселей может полностью изменить математический смысл выражения.
По оценкам исследователей в области распознавания математических выражений, точность специализированных моделей на сложных многострочных формулах остаётся заметно ниже, чем на печатном тексте, — именно из-за необходимости учитывать пространственные, а не только последовательные связи между символами.
Добавьте к этому нестандартный алфавит: греческие буквы, операторы вроде интеграла и суммы, стрелки, скобки разной высоты — и получится набор символов, который в десятки раз шире привычного латинского или кириллического текста. Для системы распознавания это означает, что придётся не просто читать, а анализировать структуру — почти как читать чертёж, а не абзац.
Двумерная структура против линейного письма
Чтобы понять природу проблемы, полезно взглянуть на неё через призму лингвистики. Обычное письмо — будь то русский, английский или любой другой алфавитный язык — устроено как линейная последовательность: один символ идёт за другим по строго заданной оси. Компьютеру достаточно двигаться вдоль этой оси и распознавать знаки один за одним, не задумываясь об их вертикальном положении.
Математическая нотация нарушает это правило почти на каждом шагу. Дробь занимает не одну, а сразу три условные зоны — числитель, линию и знаменатель, расположенные друг над другом. Степень выносится вверх и вправо от основания, а индекс — вниз и вправо. Получается, что одна и та же горизонтальная позиция на странице может содержать несколько разных, вложенных друг в друга смысловых уровней.
Именно эта особенность заставляет говорить о формуле как о двумерном объекте, а не строке символов. Сравнение хорошо иллюстрирует таблица.
| Параметр | Обычный текст | Математическая формула |
|---|---|---|
| Направление чтения | Одна ось (слева направо) | Две оси (горизонталь + вертикаль) |
| Порядок элементов | Определяется позицией в строке | Определяется позицией на плоскости |
| Вложенность | Практически отсутствует | Может достигать нескольких уровней (дробь в дроби, степень степени) |
| Алфавит | Несколько десятков символов | Сотни знаков: буквы, операторы, скобки, стрелки |
- Линейное письмо
- Способ записи, при котором смысл определяется исключительно порядком символов вдоль одной строки.
- Двумерная структура
- Способ записи, при котором смысл зависит от взаимного расположения элементов по горизонтали и вертикали одновременно.
Для алгоритма распознавания это различие оборачивается принципиально разной архитектурой решения. Системе нужно не просто «прочитать» символы, а восстановить дерево отношений между ними — понять, что вот этот маленький значок наверху является показателем степени, а не отдельной буквой в следующей строке.
Как устроен классический OCR и почему он «читает построчно»
Чтобы понять, почему формулы становятся камнем преткновения для распознавания, стоит заглянуть внутрь классической технологии OCR (Optical Character Recognition — оптическое распознавание символов). Её архитектура складывалась десятилетиями под одну конкретную задачу — читать обычный печатный или рукописный текст, устроенный линейно. И весь пайплайн буквально пронизан этим допущением.
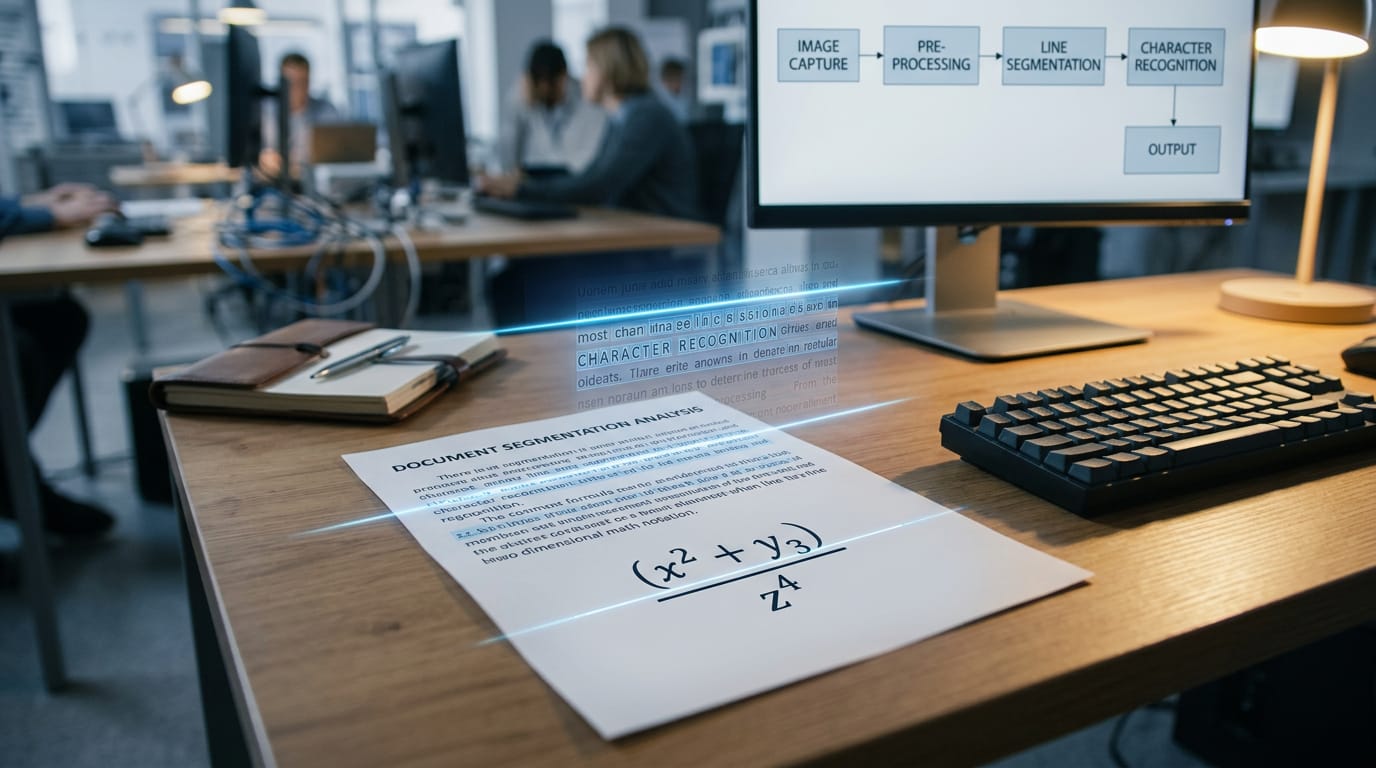
Работа классического OCR строится как последовательность строго определённых этапов, каждый из которых готовит почву для следующего:
- Предобработка изображения — коррекция наклона, устранение шума, приведение к чёрно-белому виду (бинаризация).
- Анализ макета страницы — программа определяет, где находится текст, а где иллюстрации или таблицы, и делит страницу на блоки.
- Сегментация — самый важный для нашей темы шаг: блок текста дробится на строки, строки — на слова, а слова — на отдельные знакоместа, каждое из которых должно соответствовать одному символу.
- Распознавание символов — каждый вырезанный фрагмент сравнивается с эталонными шаблонами или классифицируется алгоритмом машинного обучения.
- Постобработка — исправление ошибок с помощью словарей и грамматических правил, финальная сборка текста.
Ключевой момент — именно сегментация. Алгоритм заранее «нарезает» изображение на горизонтальные полосы-строки, а затем внутри каждой строки ищет вертикальные разрывы между символами. Это работает прекрасно для обычного текста, где буквы действительно выстроены в одну линию на одной высоте.
Сегментацией строки называется декомпозиция изображения, содержащего последовательность символов, на фрагменты, содержащие отдельные символы — этот принцип лежит в основе большинства традиционных OCR-систем и предполагает, что все символы строки расположены на одном уровне.
Проблема в том, что данный подход жёстко «зашивает» линейность прямо в архитектуру алгоритма. Система физически не умеет интерпретировать ситуацию, когда в одной горизонтальной позиции страницы одновременно находятся два, три или четыре символа на разной высоте — а именно так выглядит любая дробь, степень или индекс. OCR просто не задавался вопросом «что расположено выше или ниже», потому что для линейного текста такой вопрос не имел смысла.
- Сегментация
- Этап OCR-пайплайна, на котором изображение делится на строки, слова и отдельные символы для последующего распознавания каждого фрагмента отдельно.
Почему это архитектурное ограничение, а не просто «недоработка»
Дело не в качестве кода конкретной программы, а в исходном допущении, заложенном на этапе проектирования: текст читается вдоль одной оси. Чтобы обработать двумерные структуры, нужен принципиально другой подход к анализу изображения — именно поэтому распознавание формул выделилось в отдельное направление, а не стало просто улучшенной версией обычного OCR.
Ограничения посимвольного распознавания на примере Tesseract
Tesseract — один из самых известных и распространённых open-source движков OCR, изначально разработанный в Hewlett-Packard, а затем доведённый до современного вида усилиями открытого сообщества. Его выбирают как показательный пример именно потому, что архитектура движка прозрачно документирована и наглядно демонстрирует принципы «построчного» распознавания.
Начиная с версии 4.0, Tesseract использует нейросетевой движок на основе LSTM (Long Short-Term Memory) — рекуррентной сети, специально созданной для обработки последовательных данных. Логика работы такова: изображение строки сканируется слева направо, столбец за столбцом, и каждый вертикальный «срез» превращается в вектор признаков, который подаётся на вход сети.
Модуль Tesseract буквально «сканирует строчную картинку слева направо, превращая столбцы пиксельных данных в последовательность векторов признаков» — а затем LSTM предсказывает символ для каждого такого шага, и результаты склеиваются через CTC-декодирование (Connectionist Temporal Classification).
Этот механизм прекрасно подходит для обычного текста: он умеет учитывать контекст соседних букв, распознавать связное письмо и даже подключать словарь для проверки правдоподобия слов. Но у него есть жёсткое архитектурное условие — вход должен представлять собой уже выделенную и выпрямленную строку, где символы расположены на одной базовой линии.
Именно тут и возникают ограничения при попытке подать на вход формулу:
- Этап сегментации на строки предшествует распознаванию — если дробь занимает по высоте место сразу двух строк, алгоритм анализа макета страницы попытается разрезать её на две независимые строки текста.
- LSTM-модель обучена предсказывать символы по порядку слева направо, у неё нет механизма для интерпретации вертикальных смещений как показателей степени или индексов.
- Словарные модели постобработки, которые повышают точность на обычных словах, попросту бесполезны для математической нотации — в языковой модели Tesseract нет понятия «правильной» последовательности операторов и переменных.
На практике это означает, что при попытке распознать даже относительно простую формулу через Tesseract программа либо разрывает её на бессвязные текстовые фрагменты, либо пытается втиснуть все символы в одну строку, теряя информацию о том, что относилось к числителю, а что — к знаменателю. Дело не в качестве обучения модели, а в самой постановке задачи, для которой движок был спроектирован.
Пространственные отношения символов как главная сложность
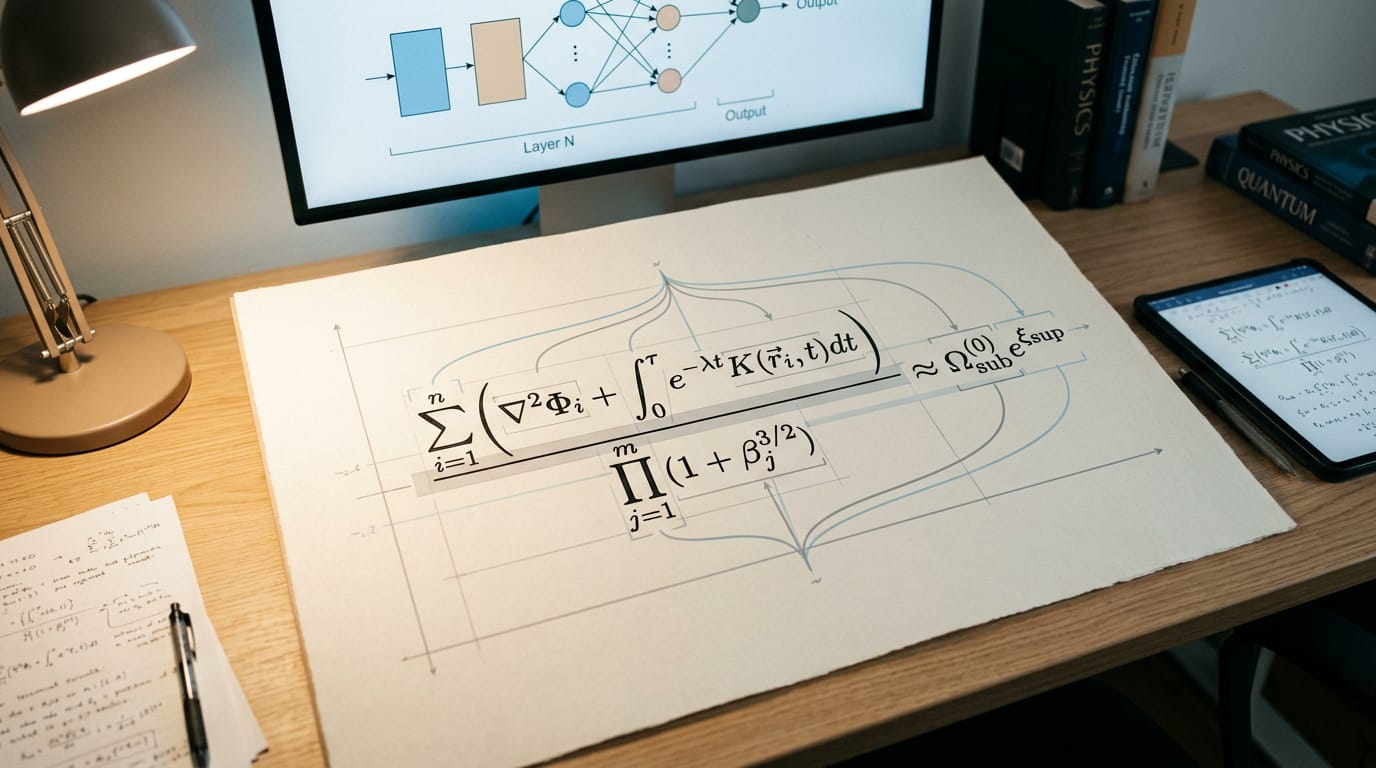
Если посимвольное распознавание — это первая стена, в которую упирается классический OCR, то вторая, куда более высокая — это пространственная организация формулы. Обычный текст читается по одной оси: слева направо, строка за строкой. Формула же использует сразу две оси одновременно — горизонтальную и вертикальную, — и смысл выражения напрямую зависит от того, где именно расположен символ относительно соседних.
Одна и та же цифра «2» может быть обычным множителем, показателем степени, индексом или частью знаменателя — единственное, что меняется, это её положение и размер шрифта. Для системы, обученной искать буквы вдоль строки, такая многозначность становится источником систематических ошибок: она видит набор символов, но не «понимает» синтаксическую роль каждого из них.
Почему это не просто «ещё один тип шума»
Разница принципиальна. Шум на изображении — смазанность, засветка, плохой скан — ухудшает распознавание уже известной структуры. А пространственная неоднозначность формулы — это проблема самой структуры: даже на идеально чистом, контрастном изображении алгоритм должен сначала восстановить геометрию выражения и только потом — его содержание.
Классическое исследование по распознаванию математических текстов показало: при переходе от обычного набранного текста к аккуратно свёрстанным двумерным формулам точность распознавания падала с 99% до 10% и ниже — притом что качество печати и чёткость символов оставались на прежнем уровне.
Разработчики UniMERNet прямо формулируют эту задачу как поиск баланса между глобальным и локальным контекстом: модели нужно одновременно понимать, где заканчивается одна логическая часть формулы и начинается другая (глобальный уровень), и как связаны между собой соседние символы — например, распознать надстрочный или подстрочный индекс (локальный уровень). Без этой двухуровневой обработки нейросеть либо теряет общую структуру выражения, либо неправильно расставляет мелкие, но критически важные детали.
- Символьное дерево (symbol layout tree)
- Способ представления формулы, в котором указывается не только последовательность символов, но и тип связи между ними: находится ли символ на общей базовой линии, выше, ниже, внутри корня или в знаменателе. Именно построение такого дерева, а не простое «чтение» символов, лежит в основе современных систем распознавания формул.
Именно поэтому оценка качества распознавания формул устроена иначе, чем для обычного текста. Метрика CDM (Character Detection Matching), используемая при тестировании UniMERNet, рендерит и предсказанную, и эталонную формулы обратно в изображения, а затем сравнивает их с учётом пространственного положения каждого символа — потому что текстовое совпадение LaTeX-кода само по себе ничего не говорит о том, сохранена ли визуальная и логическая структура выражения.
Почему нельзя просто «дописать» правила для формул
Ранние попытки решить проблему сводились к добавлению эвристик поверх линейного OCR: искать символы меньшего размера над и под строкой, отдельно детектировать дробную черту и так далее. Но у математики нет ограничения на глубину вложенности — индекс может стоять у индекса, дробь может находиться внутри корня, а тот, в свою очередь, в показателе степени. Разбор подобных выражений на основе жёстких двумерных грамматик приводит к экспоненциальному росту вычислительной сложности при переборе вариантов, поэтому такой подход плохо масштабируется на сложные реальные формулы — в отличие от обучаемых моделей, которые улавливают закономерности статистически.
Ключевое отличие двумерной записи от линейной можно свести к нескольким пунктам:
- расстояние между символами измеряется не только по горизонтали, но и по вертикали, причём оба измерения непрерывны, а не дискретны, как позиция буквы в строке;
- один и тот же символ может входить сразу в несколько пространственных отношений — быть основанием для индекса и одновременно частью более крупного выражения;
- структуры вроде матриц или систем уравнений вообще не укладываются в понятие «строки» и требуют отдельной логики разбора;
- ошибка в определении границ одного элемента (например, где заканчивается числитель) искажает интерпретацию всей формулы, а не только одного символа.
В результате распознавание формулы — это не столько задача чтения символов, сколько задача реконструкции геометрии, которая уже потом переводится в текстовый или LaTeX-формат. Именно эта особенность объясняет, почему следующие типы конструкций — дроби, индексы, суммы и интегралы — требуют отдельного разговора: каждый из них по-своему нагружает алгоритм задачей понимания вложенности и относительного положения символов.
Дроби, индексы и корни: что путает алгоритмы
Если спуститься от общей теории к конкретике, три конструкции создают алгоритмам больше всего проблем: дроби, индексы (верхние и нижние) и корни. У каждой — своя природа ошибки, но объединяет их одно: смысл определяется не тем, какой символ распознан, а тем, в какой геометрической зоне он оказался.
Начнём с индексов. Чтобы понять, является ли маленькая цифра справа от буквы показателем степени или просто соседним символом на строке, алгоритму нужно оценить относительное смещение по вертикали и разницу в размере шрифта. Эта задача решаема — но только когда символов немного. Разработчики Tesseract, обсуждая попытки приспособить движок для формул, отмечали характерный эффект: символ с одновременно верхним и нижним индексом почти никогда не распознаётся корректно, а сам движок иногда «решает», что надстрочный элемент принадлежит вовсе не текущей строке, а соседней — просто потому, что вертикальное смещение сбивает алгоритм построения строк.
Ранние исследования по анализу базовых линий показали, что различение «на строке / выше строки / ниже строки» можно автоматизировать почти безошибочно — с точностью около 99,89% — если использовать относительный размер и положение соседних символов. Проблема в том, что в реальных формулах индексы редко идут по одному: вложенные и последовательные индексы резко увеличивают число возможных геометрических комбинаций, и точность на отдельных парах символов не гарантирует правильного разбора всего выражения.
С дробями беда другого рода: границы числителя и знаменателя. Горизонтальная черта дроби — это не просто линия, а оператор группировки, определяющий, какие символы слева и справа от неё относятся к верхней части, а какие — к нижней. Когда дробная черта визуально сливается с соседним знаком «минус» или «равно», алгоритм рискует объединить два разных элемента формулы в один — например, спутать последовательность «минус, а затем дробная черта» с одной длинной чертой.
Вложенные дроби усиливают проблему многократно. Если числитель одной дроби сам содержит другую дробь, у алгоритма должно быть представление о приоритете черт: какая из них главная, а какая — вложенная. При недостаточном интервале между уровнями вложенности современные модели, включая крупные мультимодальные системы, чаще всего теряют часть содержимого именно на границе таких вложенных структур — целые слагаемые «выпадают» из результата, потому что алгоритм не может однозначно определить, к какому уровню дроби они относятся.
Корни: спрятанная граница подкоренного выражения
Радикал (знак корня) создаёл бы меньше сложностей, если бы не одна деталь: горизонтальная черта над подкоренным выражением может тянуться на произвольную длину и не имеет чёткого «конца» для алгоритма, ищущего готовые шаблоны. Ситуация усложняется вложенными корнями — когда один корень находится под другим, — из-за чего системе приходится распознавать не одну, а сразу несколько вложенных областей группировки, каждая со своей верхней границей.
| Конструкция | Что должен определить алгоритм | Типичная ошибка |
|---|---|---|
| Индекс (верхний/нижний) | Вертикальное смещение и размер шрифта символа | Индекс «улетает» в соседнюю строку или сливается с основной строкой |
| Дробь | Границы числителя и знаменателя относительно черты | Дробная черта сливается со знаком «минус» или «равно» |
| Вложенная дробь | Приоритет и уровень вложенности нескольких черт | Часть числителя или знаменателя пропадает из результата |
| Корень | Протяжённость и границу горизонтальной черты над выражением | Неверно определена область, попадающая под корень |
- Оператор группировки
- Графический элемент формулы (дробная черта, черта корня, скобки), который не имеет собственного текстового значения, но задаёт границы для других символов, определяя, что к чему относится.
Общий вывод простой: там, где человек мгновенно считывает геометрию «на глаз» — где заканчивается числитель, докуда тянется корень, какой символ к какой строке относится, — алгоритму приходится восстанавливать эти границы шаг за шагом, и любая неточность в этой реконструкции превращается в содержательную, а не косметическую ошибку.
Суммы, интегралы и пределы: проблема вложенности
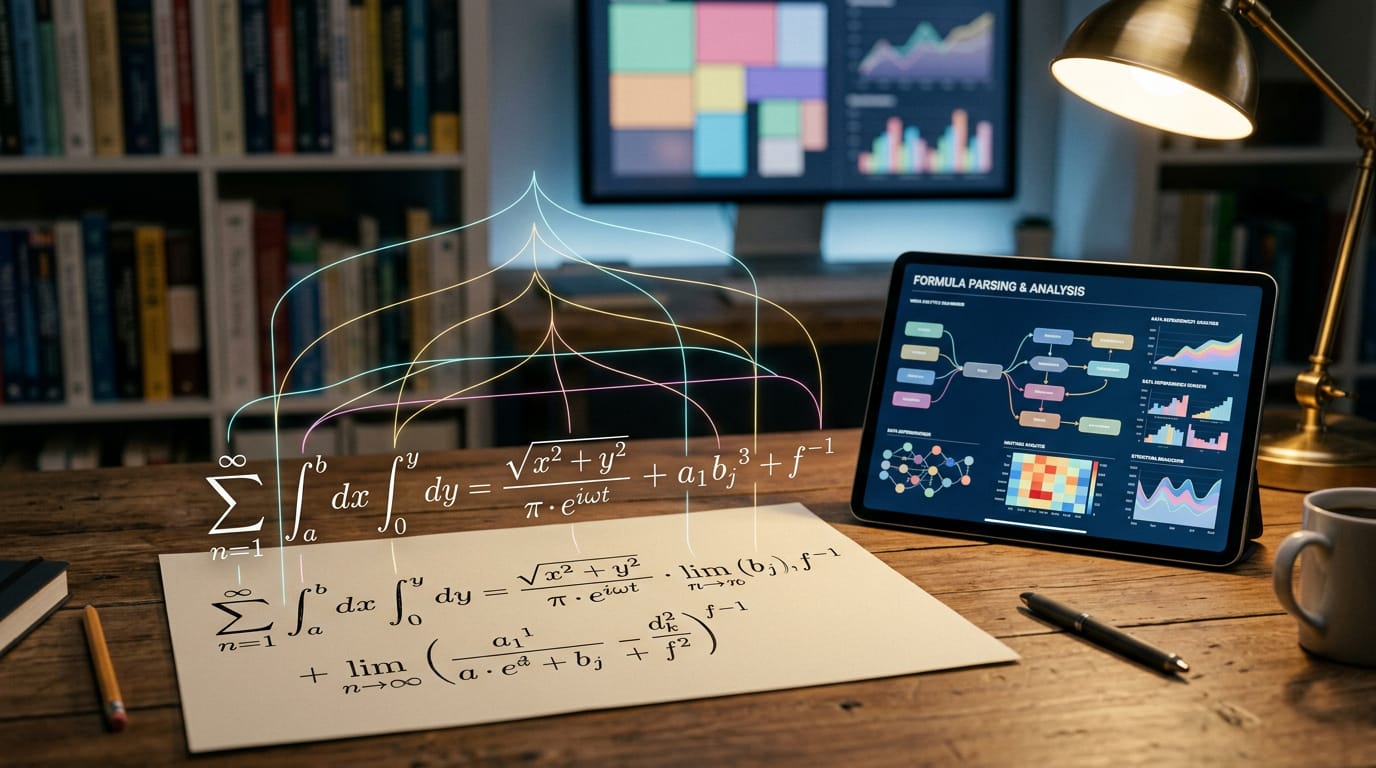
Дроби и индексы усложняют распознавание сами по себе, но настоящее испытание для алгоритма начинается там, где эти элементы начинают накладываться друг на друга. Знак суммы с пределами, интеграл с границами интегрирования, предел функции — это конструкции, у которых почти всегда есть верхняя и нижняя часть, а внутри них нередко скрывается ещё одна дробь, ещё один индекс или даже ещё одна сумма.
Возьмём типичный пример: сумму по индексу от одного значения до другого, где под знаком суммы стоит дробь с показателем степени в знаменателе. Чтобы правильно прочитать такое выражение, алгоритму нужно одновременно удержать в «памяти» четыре пространственные привязки — нижний предел, верхний предел, содержимое под знаком суммы и вложенную внутрь него дробь. Ошибка в определении любой из этих привязок разрушает всю формулу целиком, а не искажает её частично.
Что такое «степень вложенности» и почему она важна для оценки сложности
В исследовательском сообществе, занимающемся распознаванием рукописных и печатных формул (в частности, в рамках конкурса CROHME), для измерения такой сложности используется понятие degree of nestedness — степень вложенности выражения. Она показывает, сколько «уровней» пространственных отношений (индекс внутри индекса, дробь внутри показателя степени и так далее) содержится в формуле, если не учитывать простое линейное перечисление символов.
- Degree of nestedness (степень вложенности)
- Метрика, отражающая максимальную глубину дерева структурных связей в формуле — то есть сколько раз одна пространственная конструкция (индекс, дробь, корень) находится внутри другой. Выражение вида «просто сумма нескольких слагаемых» имеет нулевую вложенность, а сумма с дробью в показателе степени внутри предела интегрирования — уже несколько уровней.
Связь между вложенностью и точностью распознавания достаточно прямая, и статистика по соревнованиям CROHME это подтверждает.
По данным анализа выборок CROHME, простые формулы с несложной структурой распознаются с точностью около 87% (то есть примерно 13% ошибок), тогда как среди выражений, содержащих более 11 символов с несколькими уровнями вложенности, свыше 41% вообще ни разу не были распознаны корректно ни одной из участвовавших систем.
Отдельная сложность интегралов и пределов — асимметрия пределов относительно основного символа. У суммы и интеграла нижняя граница обычно смещена влево-вниз, а верхняя — вправо-вверх, и это смещение может быть небольшим, из-за чего алгоритму приходится буквально на глаз (точнее — по координатам пикселей) отличать «предел суммирования» от «просто следующего множителя в строке».
Современные модели решают эту проблему по-разному, но общий принцип — явный учёт структуры при генерации ответа. Например, в архитектуре TAMER, ориентированной на рукописные формулы, отдельно отслеживается точность так называемого bracket matching — согласованности открывающих и закрывающих структурных элементов (в том числе пар «нижний предел — верхний предел»): по заявленным авторами данным, этот показатель держится на уровне более 92% даже при высокой структурной сложности формулы, что заметно выше, чем у моделей без такого механизма.
Итог для трёх рассмотренных конструкций одинаков: чем больше уровней вложенности содержит формула, тем выше риск, что алгоритм «потеряет нить» где-то на середине разбора. Это принципиально отличает математическую нотацию от текста, где даже очень длинное предложение остаётся линейной последовательностью слов без необходимости удерживать многоуровневую геометрическую структуру.
Почему длина формулы важнее, чем кажется
В обычном тексте увеличение длины предложения почти не увеличивает риск ошибки распознавания отдельного слова — контекст, наоборот, помогает угадать нечёткие буквы. В формулах всё наоборот: каждый добавленный уровень вложенности умножает число возможных вариантов интерпретации геометрии, а не складывает их. Поэтому даже небольшое увеличение сложности выражения — скажем, добавление ещё одного вложенного индекса — может непропорционально сильно снизить вероятность полностью верного распознавания всей формулы.
Визуально похожие символы и потеря смысла
Даже если алгоритм безошибочно определил геометрию формулы — где заканчивается числитель, куда относится индекс, — остаётся ещё одна ловушка: сами символы математики часто выглядят почти неотличимо друг от друга. В обычном тексте похожие буквы редко меняют смысл слова кардинально, а вот в формуле подмена одного знака другим способна превратить верное уравнение в бессмысленное или, что хуже, в правдоподобное, но неверное.
Проблема носит системный характер и хорошо описана в работе создателей UniMERNet: они прямо называют визуальное сходство символов одним из трёх фундаментальных источников ошибок при распознавании формул, наряду со сложностью структуры и разнообразием почерков. В качестве характерных примеров разработчики приводят пары строчной греческой «мю» и латинской «u», а также строчной «бета» и заглавной латинской «B» — на многих шрифтах и при невысоком разрешении снимка эти символы различаются буквально долями миллиметра.
- Гомоглиф (homoglyph)
- Термин, обозначающий два разных символа, которые визуально совпадают или почти совпадают при определённом начертании шрифта. В обычных текстах классический пример — путаница между заглавной латинской «O» и цифрой «0» или между строчной «l», заглавной «I» и цифрой «1». В математике список гомоглифов значительно шире за счёт греческого алфавита, специальных операторов и рукописных начертаний.
Масштаб проблемы наглядно виден на количественных тестах. Исследование STEM-POM, где крупные языковые модели, включая GPT-4o и Claude 3.5, проверялись на способности классифицировать математические символы в реальных научных текстах, зафиксировало заметный разброс ошибок по конкретным знакам.
По данным тестирования STEM-POM, даже у лучшей из проверенных моделей ошибка классификации для греческой буквы «мю» составила около 24%, а для «пи» — около 18%; у менее производительных моделей показатели ошибок для похожих символов доходили до 50–59%. Отдельно отмечается, что символы вроде «альфа» и заглавной «сигма» путаются между собой систематически из-за пересекающихся ролей — один и тот же значок может обозначать то переменную, то оператор суммирования, в зависимости от контекста.
Похожая логика работает и на уровне отдельных начертаний, не связанных с греческим алфавитом. Ниже — типичные пары символов, которые чаще всего путают системы оптического распознавания в математическом контексте.
- заглавная латинская «O» и цифра «0» — различие часто сводится к едва заметному наклону или пропорциям овала в конкретном шрифте;
- строчная «l», заглавная «I» и цифра «1» — по данным тестов на смешанных текстах, ошибка распознавания для этой тройки символов может достигать 15–16%, что заметно выше, чем для большинства других символов;
- умножение «×» и переменная «x» — визуально почти идентичны, но меняют роль символа с оператора на переменную (подробнее — в следующем разделе);
- штрих производной и апостроф или запятая — тонкая косая черта легко теряется при сжатии изображения или низком разрешении скана.
Есть и более тонкий источник ошибок — контекстная многозначность. Один и тот же значок «Σ» может обозначать сумму как оператор или использоваться как обозначение конкретной величины (например, дисперсии в статистике), а «Δ» — быть и оператором приращения, и самостоятельной константой. Алгоритм не может определить это только по форме символа: ему нужно опираться на соседние элементы формулы и общий контекст, а этого понимания у чисто визуальных моделей распознавания часто нет.
Почему увеличение разрешения снимка не решает проблему полностью
Казалось бы, если символы путаются из-за нечёткости, достаточно просто повысить качество фотографии или скана. Отчасти это помогает — и об этом будет отдельный разговор дальше в статье, — но полностью проблему не снимает. Часть визуально похожих символов (например, «мю» и «u», «альфа» и «а» в некоторых рукописных стилях) совпадают по форме не из-за размытости изображения, а по своей исходной геометрии в конкретном шрифте или почерке. В таких случаях даже при максимальной чёткости снимка отличить символы можно только по контексту формулы, а не по одному лишь начертанию.
Итог таков: точное построение геометрии формулы решает только половину задачи. Вторая половина — правильная интерпретация того, что именно изображено в каждой геометрической позиции, — требует уже не столько анализа формы линий, сколько понимания математического и предметного контекста, в котором эта формула существует.
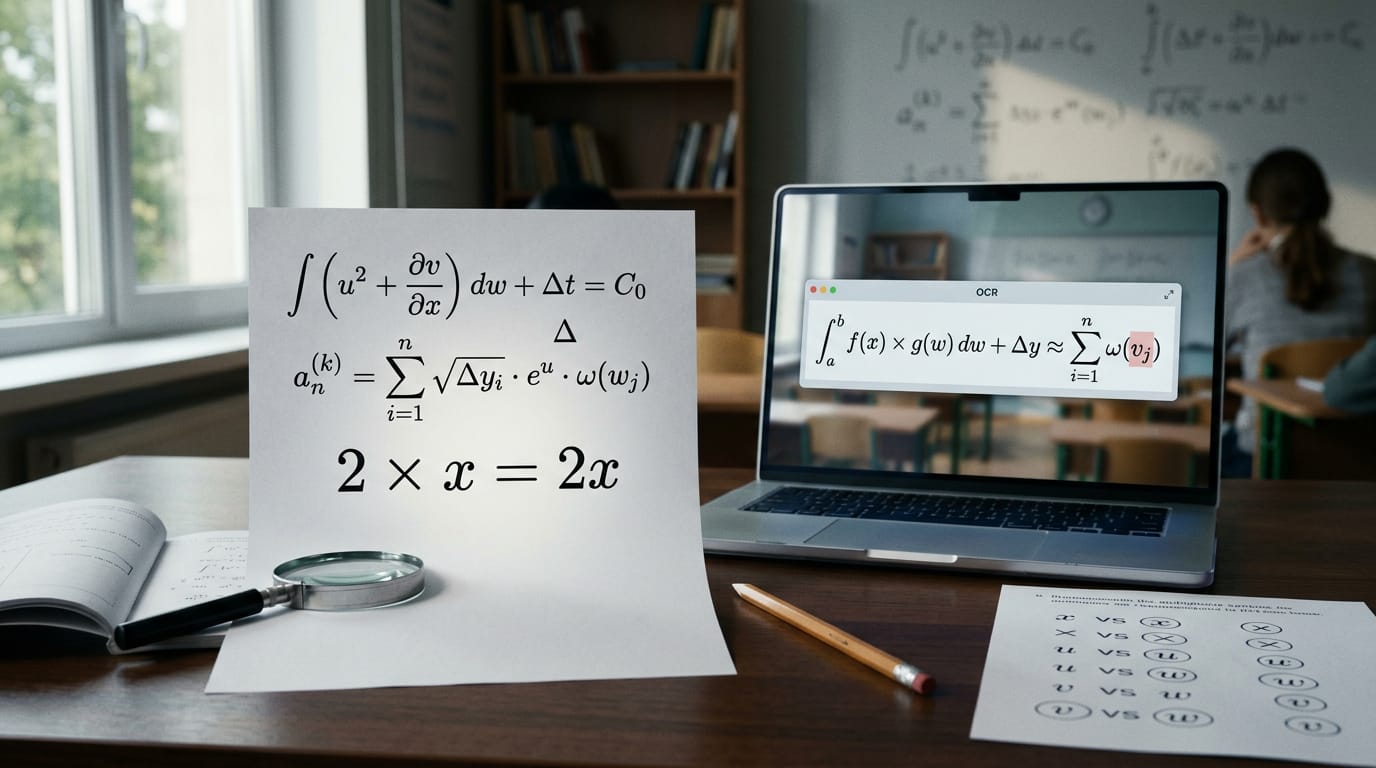
Когда «×» превращается в «x»: цена одной ошибки
Знак умножения «×» и латинская буква «x» — почти идеальные близнецы по начертанию, особенно в курсивном или наклонном шрифте, где оба символа превращаются в едва заметный крестик или наклонную черту. Но в математическом смысле это два принципиально разных объекта: одно — оператор, действие над числами, другое — переменная, неизвестная величина. Подмена одного другим не искажает формулу косметически, а меняет её роль целиком.
Показателен пример из практики распознавания рукописных выражений: запись «икс в квадрате» алгоритм без структурного анализа геометрии способен прочитать как «икс умножить на два», просто потому что верхний индекс визуально расположен рядом с основным символом почти так же, как второй множитель в строке. Разница между x² и x×2 кажется крошечной на пиксельном уровне, но с точки зрения математики это два разных выражения с разными значениями при любом x, кроме одного частного случая.
Специалисты, анализирующие типичные сбои OCR-систем при работе с формулами, описывают эту категорию ошибок термином «confident but wrong» — «уверенно, но неверно»: алгоритм не сообщает о неуверенности и не помечает результат как сомнительный, а выдаёт синтаксически корректное, но семантически ошибочное выражение, которое выглядит вполне правдоподобно для человека, бегло проверяющего результат.
Похожая история происходит и с другими операторами и переменными. Разработчики, тестировавшие крупные мультимодальные модели на распознавании формул, отмечали систематическую ошибку: буквы «u», «v» и «w» — стандартные обозначения векторов — модель принимала за «жирное» начертание символов и добавляла в LaTeX-код лишнее форматирование, хотя в оригинале никакого выделения не было. Ошибка выглядела безобидно на первый взгляд, но искажала математический смысл: жирный шрифт в формулах — это не украшение, а отдельное обозначение (например, вектора в отличие от скаляра), и его добавление там, где его не было, меняет интерпретацию всей записи.
Почему одна ошибка «стоит» дороже, чем кажется
Разница между ошибкой распознавания в обычном тексте и в формуле — в характере последствий:
- в тексте опечатка вроде «дом» вместо «том» обычно улавливается по контексту предложения и не меняет общий смысл абзаца;
- в формуле замена одного символа полностью меняет вычисляемое значение, а не искажает его на процент-два;
- ошибка не локализуется — если результат распознавания используется дальше (например, для проверки решения студента или для автоматических вычислений), неверный символ passes through весь последующий процесс без предупреждения;
- визуальная убедительность результата мешает человеку заметить ошибку при беглой проверке — синтаксически корректная, но неверная формула выглядит так же «нормально», как и правильная.
Отдельно стоит случай замены заглавной греческой «дельта» (Δ) на латинскую «A» — ошибка, документированная в практике распознавания инженерных и физических текстов. Формула вида «ΔH» (изменение энтальпии) при такой подмене превращается в «AH», то есть теряет физический смысл разности величин и превращается в бессмысленное произведение или обозначение неизвестной переменной.
- Семантическая ошибка распознавания
- Тип ошибки OCR, при котором результат синтаксически корректен (представляет собой валидное математическое или LaTeX-выражение), но не соответствует по смыслу исходной формуле. В отличие от явного «мусора» на выходе, такую ошибку сложно обнаружить автоматически, поскольку формальная проверка синтаксиса её не выявляет.
Именно из-за подобных случаев специалисты, работающие с автоматическим распознаванием формул для последующих вычислений или проверки решений, рекомендуют не доверять результату полностью, а сверять его хотя бы выборочно с оригиналом — особенно в тех местах, где встречаются потенциально неоднозначные операторы и переменные.
Рукописный ввод против печатного текста
До сих пор речь шла о формулах в целом, но природа изображения — печатный текст или рукописный ввод — добавляет к задаче ещё одно измерение сложности. Печатная формула в учебнике или статье подчиняется строгим правилам шрифта: одинаковая высота символов одного типа, ровная базовая линия, предсказуемые пропорции индексов. Рукописная запись — будь то конспект студента или фото решения на бумаге — этих гарантий не даёт вообще.
Разброс становится особенно заметным, когда нужно быстро распознать формулу на фото школьной тетради или конспекта: почерк может съезжать по строке, менять наклон посреди выражения, а индексы — оказываться на одной высоте с основным символом просто из-за неаккуратного письма. Алгоритму приходится не только восстанавливать структуру формулы, но и предварительно компенсировать индивидуальные особенности конкретного почерка, которых в печатном тексте попросту не существует.
Разница в сложности хорошо видна на количественных результатах современных моделей. Разработчики UniMERNet отдельно выделяют категорию HWE (Handwritten Expressions, рукописные выражения) как одну из четырёх базовых сцен распознавания наряду с чисто печатными (SPE), формулами из составных документов (CPE) и снимками с экрана (SCE) — и результаты по этим категориям заметно расходятся.
| Тип изображения | Метрика BLEU (UniMERNet) | Точность полного совпадения (ExpRate на CROHME) |
|---|---|---|
| Печатная формула (SPE) | ≈0,92 | 93% и выше на аккуратно свёрстанных данных |
| Формула из составного документа (CPE) | ≈0,92 | — |
| Снимок с экрана (SCE) | ≈0,62 | — |
| Рукописное выражение (HWE) | ≈0,92 (у лучших моделей после спецнастройки) | 65–68% на конкурсных наборах CROHME |
По данным конкурсов CROHME, где системы соревнуются именно на рукописных формулах, лучшие модели полностью верно распознают порядка 65–68% выражений, тогда как для аккуратно набранных печатных формул показатель точного совпадения превышает 90%. Для сравнения, модель TexTeller, ориентированная на масштабное обучение, достигает 88% точного совпадения на CROHME 2014 и около 90,7% на наборе HME100K — но это всё ещё заметно ниже результатов, типичных для печатного текста.
Причины такого разрыва понятны, если разложить их на конкретные факторы:
- непостоянство наклона и размера символов — один и тот же человек пишет одну и ту же цифру по-разному в разных частях формулы;
- отсутствие строгой базовой линии — рукописный текст «плавает» по вертикали сильнее, чем печатный, что затрудняет определение индексов;
- индивидуальные сокращения и стилизация символов — например, рукописная интегральная закорючка у разных людей выглядит по-разному, в отличие от единого шрифтового начертания;
- артефакты съёмки — рукописные формулы чаще фотографируют, а не сканируют, что добавляет тени, блики и перспективные искажения.
- Online и offline распознавание рукописного ввода
- В исследовательской литературе различают два сценария: online-распознавание, когда система получает данные о самой траектории письма (последовательность штрихов, как при вводе стилусом), и offline-распознавание, когда доступно только готовое растровое изображение — как при фотографировании тетради. По данным конкурса CROHME, точность распознавания при переходе от online к offline формату падает: например, на данных CROHME 2019 показатель снизился с 80,73% до 77,15% именно из-за потери информации о порядке и направлении штрихов.
Именно поэтому специализированные модели для рукописного ввода обучаются на отдельных крупных выборках вроде HME100K, содержащей около 100 тысяч рукописных формул от порядка 10 тысяч разных авторов — такой объём и разнообразие почерков нужны, чтобы модель могла обобщать индивидуальные особенности письма, а не подстраиваться под конкретный стиль.
Как современные нейросети решают задачу распознавания формул
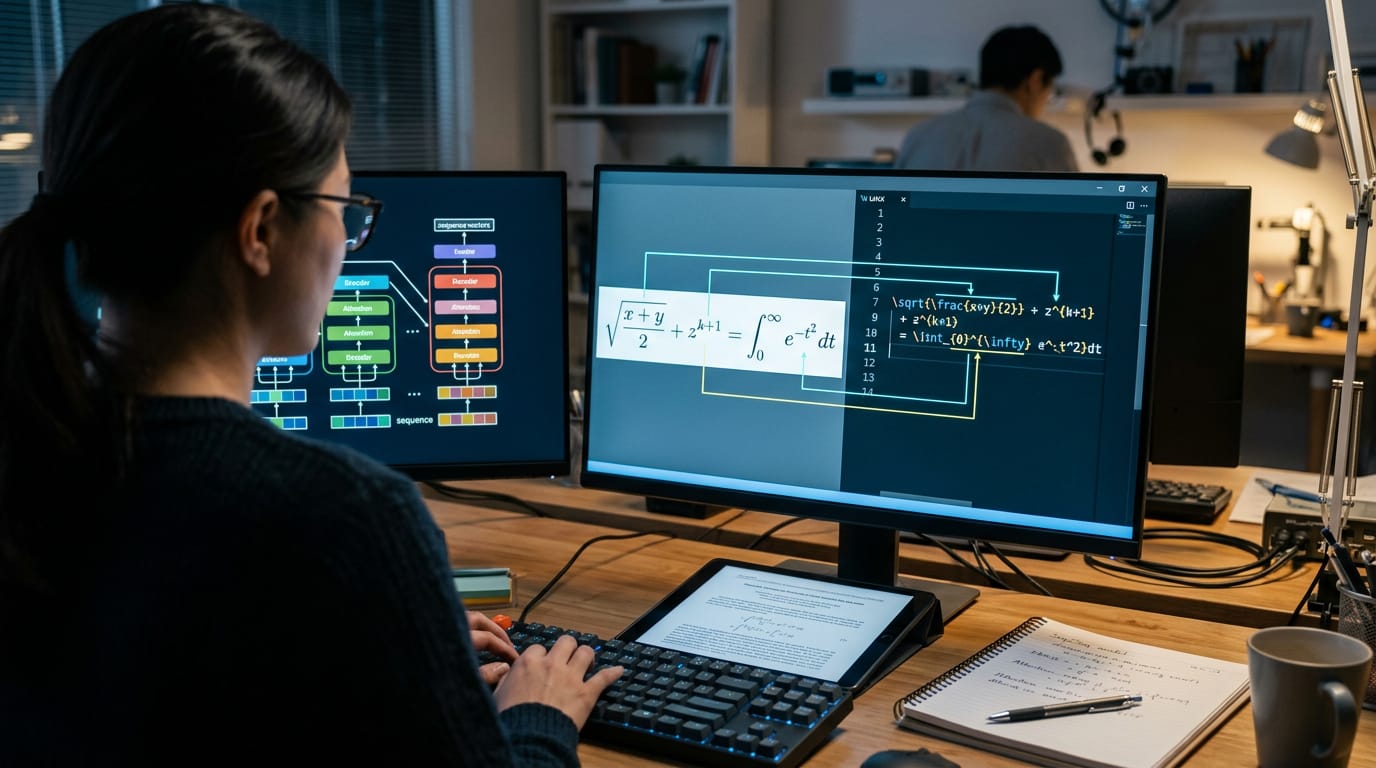
Все проблемы, описанные выше — двумерная структура, вложенность, визуально похожие символы, разница между печатью и почерком, — заставили разработчиков отказаться от классической схемы «найти строку → распознать символ» и перейти к принципиально иной архитектуре. Современные системы распознавания формул строятся по схеме encoder-decoder (кодировщик-декодировщик), заимствованной из области машинного перевода, и это не случайное совпадение: перевод изображения формулы в LaTeX-код — по сути та же задача перевода, только с «языка изображений» на язык математической разметки.
Работает это так: кодировщик, обычно построенный на основе свёрточной сети или визуального трансформера, «просматривает» изображение целиком и превращает его в набор числовых признаков — векторов, которые описывают не отдельные пиксели, а содержательные элементы картинки: линии, дуги, штрихи, их взаимное расположение. Декодировщик затем шаг за шагом генерирует выходную последовательность символов LaTeX, причём на каждом шаге он «спрашивает» у представления изображения, на какую именно область нужно посмотреть, чтобы предсказать следующий символ.
Этот механизм «спрашивания» называется cross-attention (перекрёстное внимание), и именно он решает главную проблему, из-за которой линейный OCR не справляется с формулами. Вместо того чтобы двигаться по строке слева направо с фиксированным шагом, декодировщик на каждом шаге заново оценивает, какая часть изображения сейчас релевантна — будь то основная строка, верхний индекс, содержимое под корнем или предел суммирования — и удерживает эту связь независимо от того, как далеко на изображении она расположена.
- Cross-attention (перекрёстное внимание)
- Механизм в нейросетевой архитектуре, при котором декодировщик на каждом шаге генерации формирует «запрос» и сопоставляет его со всеми признаками, извлечёнными кодировщиком из изображения, определяя, какие области картинки наиболее важны для предсказания текущего символа. Именно этот механизм заменяет жёсткую построчную логику классического OCR на гибкое, контекстно-зависимое считывание двумерной структуры.
На практике архитектуры уточняют этот общий принцип дополнительными модулями, нацеленными именно на проблемы формул. Например, в модели UniMERNet кодировщик дополнен модулем Fine-Grained Embedding для учёта мелких деталей символов и модулем Convolutional Enhancement для локального пространственного контекста, а декодировщик использует упрощённый механизм Squeeze Attention, ускоряющий генерацию длинных и сложных выражений без потери точности.
Авторы UniMERNet прямо формулируют задачу кодировщика как одновременный учёт глобального контекста — общей структуры формулы — и локального контекста — точных пространственных связей между соседними символами вроде индексов. Именно баланс между этими двумя уровнями, по их данным, определяет, распознает ли модель формулу целиком верно или лишь частично.
Есть и принципиальное отличие в том, как такие модели оцениваются. Поскольку одна и та же формула может быть корректно записана в LaTeX разными способами (например, с разным порядком необязательных пробелов или скобок), простое посимвольное сравнение строк текста работает плохо. Поэтому для оценки точности используется метрика CDM (Character Detection Matching): предсказанный и эталонный LaTeX-код независимо визуализируются обратно в изображения, а затем эти изображения сравниваются символ за символом с учётом их пространственного положения — то есть проверяется не текстовое, а визуальное и структурное совпадение.
В сумме современный подход к распознаванию формул строится на трёх взаимосвязанных решениях:
- отказ от построчного сканирования в пользу генерации всей структуры сразу через механизм внимания;
- явное разделение задачи на «понимание геометрии» (кодировщик) и «генерацию корректной разметки» (декодировщик);
- обучение на больших и разнородных выборках, включающих печатные, рукописные и скриншотные формулы, чтобы модель обобщала закономерности, а не запоминала конкретные шрифты.
Именно эта смена архитектурной парадигмы — от жёстких правил к обучаемым моделям с гибким вниманием — объясняет, почему за последние годы точность распознавания сложных формул выросла в разы по сравнению с попытками адаптировать классический OCR под математику.
Специализированные модели: UniMERNet, Pix2Text, Mathpix и PaddleOCR
Раз универсальные нейросети вроде классических трансформеров плохо справляются с двумерной структурой формул «из коробки», разработчики пошли другим путём — стали создавать узкоспециализированные модели распознавания математических выражений (Mathematical Expression Recognition, MER). Их не учат читать любой текст: единственная задача — превратить изображение формулы в корректный код LaTeX или MathML, сохранив все пространственные связи между символами.
UniMERNet — один из самых заметных проектов последних лет, разработанный Shanghai AI Lab. Его архитектура построена на связке Swin Transformer в роли энкодера и mBART в роли декодера: энкодер извлекает из картинки иерархичные визуальные признаки на нескольких масштабах, а декодер последовательно генерирует LaTeX-код, «читая» эти признаки через механизм внимания. Ключевая находка авторов — модуль Length-Aware Module, который заранее прогнозирует длину итоговой формулы. Это звучит как техническая деталь, но именно она решает частую проблему: без неё модели часто «обрывали» длинные формулы или, наоборот, зацикливались, бесконечно повторяя один и тот же фрагмент.
По данным разработчиков, UniMERNet обучен на датасете UniMER-1M — более миллиона пар «изображение-формула», включающих печатные, рукописные, зашумлённые и снятые с экрана выражения, что заметно повышает устойчивость модели к реальным, не «стерильным» снимкам.
Pix2Text (или P2T) выбрал другую стратегию — модульность вместо монолита. Это не одна нейросеть, а конвейер из нескольких моделей, работающих последовательно:
- детектор формул (Mathematical Formula Detection) находит на странице области с математикой, аналогично тому, как object detection находит объекты на фото;
- распознаватель формул (Mathematical Formula Recognition) переводит найденные области в LaTeX;
- отдельный текстовый OCR-движок обрабатывает всё, что осталось — обычные слова и предложения;
- финальный модуль склеивает результаты в единый связный текст с формулами.
Такое разделение труда позволяет Pix2Text работать даже на сравнительно слабом «железе» — авторы позиционируют его как компактную бесплатную альтернативу Mathpix, способную распознавать более 80 языков одновременно с формулами.
Mathpix — коммерческий сервис, который многие студенты и учёные уже воспринимают как отраслевой стандарт для конвертации сканов и фото в LaTeX. Технические детали архитектуры компания не раскрывает полностью, но независимые тесты подтверждают, что по совокупному качеству Mathpix действительно опережает многие открытые решения.
| Модель / инструмент | Тип формул (лучший результат) | Точность / метрика |
|---|---|---|
| Mathpix | Простые печатные формулы (SPE) | 97,29% (CDM-метрика) |
| Mathpix | Полное совпадение формулы целиком | 62,92% случаев — без единой ошибки |
| PP-FormulaNet_plus-L (PaddleOCR) | Формулы на английском | 92,22 BLEU |
| PP-FormulaNet_plus-L (PaddleOCR) | Формулы на китайском | 90,64 BLEU |
Эта таблица показывает важную деталь: даже у лидера рынка доля полностью безошибочных распознаваний сложных формул — заметно ниже 100%, хотя метрики «похожести» результата на эталон (вроде CDM или BLEU) остаются высокими. Это отражает суть проблемы, о которой шла речь выше: одна перепутанная скобка или неверно определённый индекс полностью меняет смысл формулы, даже если визуально результат выглядит «почти правильным».
PaddleOCR, разрабатываемый командой Baidu, пошёл по пути постоянного наращивания линейки моделей семейства PP-FormulaNet. Базовая версия PP-FormulaNet-S, построенная на backbone PPHGNetV2, ориентирована на скорость: она примерно в 16 раз быстрее аналогов сопоставимой точности. Более тяжёлая PP-FormulaNet-L, использующая визуальный энкодер Vary-ViT-B, выигрывает по точности за счёт более глубокого анализа изображения, а версии «plus» дополнительно дообучены на расширенном датасете из четырёх миллионов пар формул, собранных из статей arXiv.
Почему модели показывают разную точность на английских и китайских формулах
Формулы, встречающиеся в китайских научных текстах, чаще включают иероглифические подписи, нестандартные обозначения единиц измерения и специфичное форматирование, из-за чего обучающих примеров для них исторически было меньше. Это объясняет, почему у ранних версий PP-FormulaNet разрыв между En-BLEU и Zh-BLEU достигал почти 45 процентных пунктов — расширение обучающей выборки в версии plus сократило этот разрыв более чем вдвое.
Общая логика у всех четырёх решений схожая: заменить посимвольное распознавание на генерацию структурированного кода, который изначально способен выразить двумерные отношения — вложенность, надстрочные и подстрочные позиции, дроби. Разница — в архитектурных деталях, объёме обучающих данных и балансе между скоростью и точностью, который каждая команда выбирает по-своему.
Роль LaTeX и MathML как целевого формата вывода
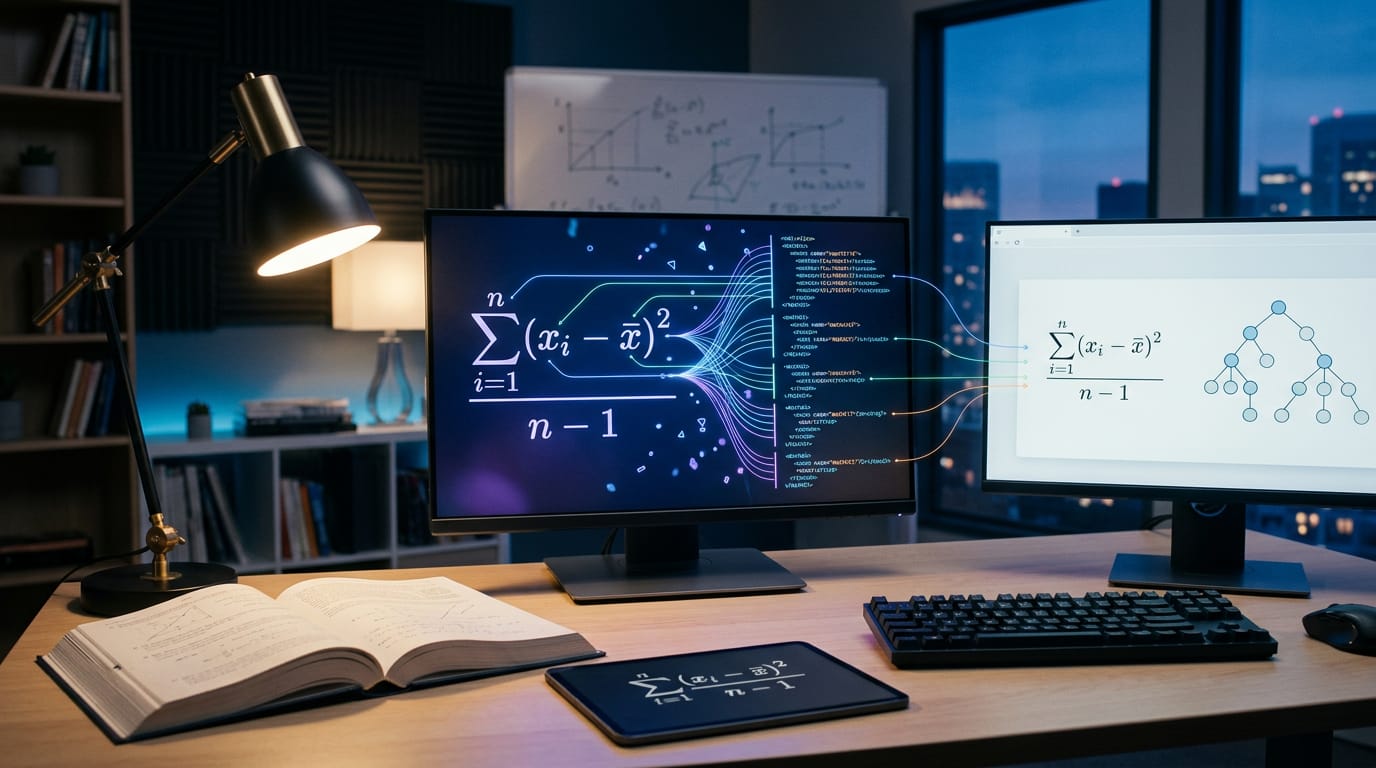
Все специализированные модели, о которых шла речь выше, объединяет одна общая черта: они не пытаются «нарисовать» распознанную формулу заново или описать её обычными словами. Вместо этого нейросеть генерирует структурированный текстовый код — как правило, на языке LaTeX или в формате MathML. Это принципиальный архитектурный выбор, и он объясняет, почему современные системы вообще смогли сдвинуться с мёртвой точки там, где посимвольный OCR буксовал.
Проблема классического распознавания, как обсуждалось ранее, в том, что обычный текстовый вывод — это плоская строка символов. У неё нет способа сказать «этот индекс относится именно к этой букве» или «эта дробь начинается здесь и заканчивается там». LaTeX решает эту задачу за счёт вложенной командной разметки: запись вида \frac{a}{b} однозначно фиксирует, что именно числитель, а что знаменатель, независимо от того, как символы физически расположены на изображении.
- LaTeX
- система вёрстки и язык разметки, изначально созданный для набора научных текстов; описывает структуру формулы через текстовые команды (например,
\sum_{i=1}^{n}для суммы с пределами). - MathML
- основанный на XML стандарт W3C для представления математических выражений в вебе; в отличие от LaTeX, машиночитаем «нативно» и не требует дополнительного парсера для интерпретации структуры.
Именно эта однозначность и делает LaTeX удобной целью для нейросети: вместо того чтобы гадать, как визуально разместить символы, модели достаточно один раз правильно определить синтаксическую структуру — а дальше рендеринг возьмёт на себя стандартный LaTeX-движок. Иными словами, сеть переводит зрительную задачу в лингвистическую: не «нарисуй похоже», а «опиши код, который при компиляции даст то же изображение».
У MathML своя ниша, тесно связанная с доступностью. В отличие от LaTeX, который при компиляции превращается в статичную картинку без внутренней семантики, MathML сохраняет структуру формулы прямо в разметке страницы — с тегами вроде для дроби или для степени.
Скринридеры вроде JAWS и NVDA (в связке с плагином MathCAT) способны корректно озвучивать именно MathML-разметку: тег
программа прочитает как «дробь», а не как случайный набор символов — тогда как обычный LaTeX-код, скомпилированный в PDF, для незрячего пользователя остаётся недоступным изображением без всякой смысловой структуры.
На практике это создаёт своеобразное разделение труда между форматами:
- LaTeX — стандарт для научных публикаций, студенческих работ и площадок вроде Overleaf, где важны компактность записи и совместимость с издательскими системами;
- MathML — стандарт для веба и электронных учебников, где формула должна не только отображаться, но и быть доступной для голосового чтения и адаптивного масштабирования;
- большинство современных инструментов, включая MathJax, умеют конвертировать LaTeX в MathML «на лету», поэтому распознающей модели обычно достаточно освоить только один из двух форматов как основной.
Именно поэтому почти все модели распознавания формул — от Mathpix до PaddleOCR — в качестве основного выходного формата используют именно LaTeX, а не MathML: он компактнее для генерации токен за токеном, у него огромная обучающая база (миллионы формул из статей на arXiv уже размечены в LaTeX-виде), и при необходимости результат легко доконвертировать в MathML отдельным, хорошо отработанным шагом.
Почему нельзя было придумать формат попроще
Теоретически можно было бы генерировать координаты каждого символа на изображении и его смысловую роль отдельным списком, но такой подход резко усложнил бы обучение: пришлось бы одновременно решать задачи детекции объектов и понимания синтаксиса. LaTeX и MathML уже содержат многолетний опыт формализации математической записи, поэтому переиспользование готового языка вместо изобретения нового оказалось значительно эффективнее с точки зрения и разработки моделей, и совместимости с существующей научной инфраструктурой.
Влияние качества снимка на точность распознавания
Даже самая совершенная модель распознавания формул — будь то UniMERNet или коммерческий Mathpix — работает не с абстрактной математикой, а с конкретной сеткой пикселей. Если исходное изображение размыто, перекошено или снято под углом, нейросеть вынуждена «додумывать» детали, которых физически нет в кадре. И здесь формулы страдают заметно сильнее обычного текста: там, где OCR может опереться на контекст слова и угадать нечёткую букву по соседним, у математического символа контекста часто нет вовсе — единственная опора для распознавания дроби или индекса это чёткость самой линии.
Ключевой параметр, определяющий качество исходника — разрешение, измеряемое в точках на дюйм (dots per inch, DPI). Ниже приведена ориентировочная зависимость точности распознавания текста от разрешения скана, которая помогает понять масштаб проблемы.
| Разрешение | Типичный источник | Точность распознавания символов |
|---|---|---|
| 72–100 DPI | Скриншот, снимок с экрана | 40–70%, часто непригодно для использования |
| 150 DPI | Быстрое сканирование, недорогой сканер | 85–92% |
| 200 DPI | Минимум для серьёзной работы | 94–97% |
| 300 DPI | Отраслевой стандарт | 97–99% |
| 400–600 DPI | Мелкий шрифт, плотные таблицы | 98–99%, дальнейший рост незначителен |
Для формул эта зависимость даже жёстче, чем для обычного текста. Верхний и нижний индекс — это часто уменьшенная в полтора-два раза копия основного символа, и при недостаточном разрешении система физически не может отличить крошечную «i» в показателе степени от шума на изображении. То же касается тонких линий дробной черты или знака интеграла, которые при пересжатии в низком качестве могут просто «раствориться» в фоне.
По данным сравнительных тестов OCR-систем, скан с разрешением 150 DPI вместо стандартных 300 DPI снижает точность распознавания на 15–20%, а фотография с телефона в условиях плохого освещения нередко упирается в потолок точности около 80–85% независимо от того, какая модель её обрабатывает.
Второй по значимости фактор — геометрические искажения: наклон кадра (skew) и перспективные искажения при фотографировании учебника или доски под углом. Для формул это особенно критично, потому что распознавание опирается на точное относительное расположение символов по вертикали и горизонтали — а именно эти координаты наклон и «съедает» в первую очередь.
- поворот текста всего на 5 градусов способен снизить точность распознавания на 10–15%;
- при наклоне в 15 градусов потери точности достигают 30–40%;
- для формул с индексами и надстрочными знаками эффект усиливается: алгоритму становится сложно понять, относится ли символ к основной строке или смещён вверх/вниз намеренно, автором формулы, а не из-за перекоса камеры.
Третий фактор — шум и контраст. Пятна на бумаге, блики от лампы на глянцевой странице учебника, artefacts от сжатия JPEG или банальная тень от руки при фотографировании тетради — всё это создаёт ложные визуальные структуры, которые модель может принять за дополнительные символы или, наоборот, спутать реальный символ с шумом.
- Бинаризация
- техника предобработки изображения, при которой каждый пиксель приводится к чёрному или белому цвету по порогу яркости; убирает промежуточные оттенки серого, из-за которых слабоконтрастный текст сливается с фоном.
- Деnoise (шумоподавление)
- алгоритмическая фильтрация случайных светлых и тёмных точек на изображении, не относящихся к самому тексту или формуле.
Показательный пример: документ с изначальной точностью распознавания 85% после применения шумоподавления способен подняться до 94–96% — притом что сама распознающая модель при этом не менялась вообще. Это подчёркивает важную деталь, о которой часто забывают пользователи: качество итогового LaTeX-кода формулы зависит не только от того, насколько «умна» нейросеть, но и от того, что именно попало ей на вход ещё до начала анализа.
Почему формулы более требовательны к качеству снимка, чем обычные предложения
Языковые модели, распознающие обычный текст, опираются на статистику языка: даже если одна буква размыта, слово можно восстановить по контексту остальных букв и вероятностям встречаемости слов. У математической нотации такого «страховочного» механизма почти нет — единственная буква переменной (например, одинокая «n» или «k») может быть корректной сама по себе, и алгоритму не на что опереться, чтобы проверить, не перепутал ли он её с похожим символом из-за размытия картинки.
Практические советы для более точного результата
Зная, какие именно факторы «ломают» распознавание формул, легко превратить эту теорию в конкретные действия. Хорошая новость в том, что большинство улучшений не требуют специального оборудования — достаточно немного изменить привычки фотографирования и подготовки снимка.
Начать стоит с самого процесса съёмки, потому что исправить плохо снятый кадр программными средствами получается лишь частично.
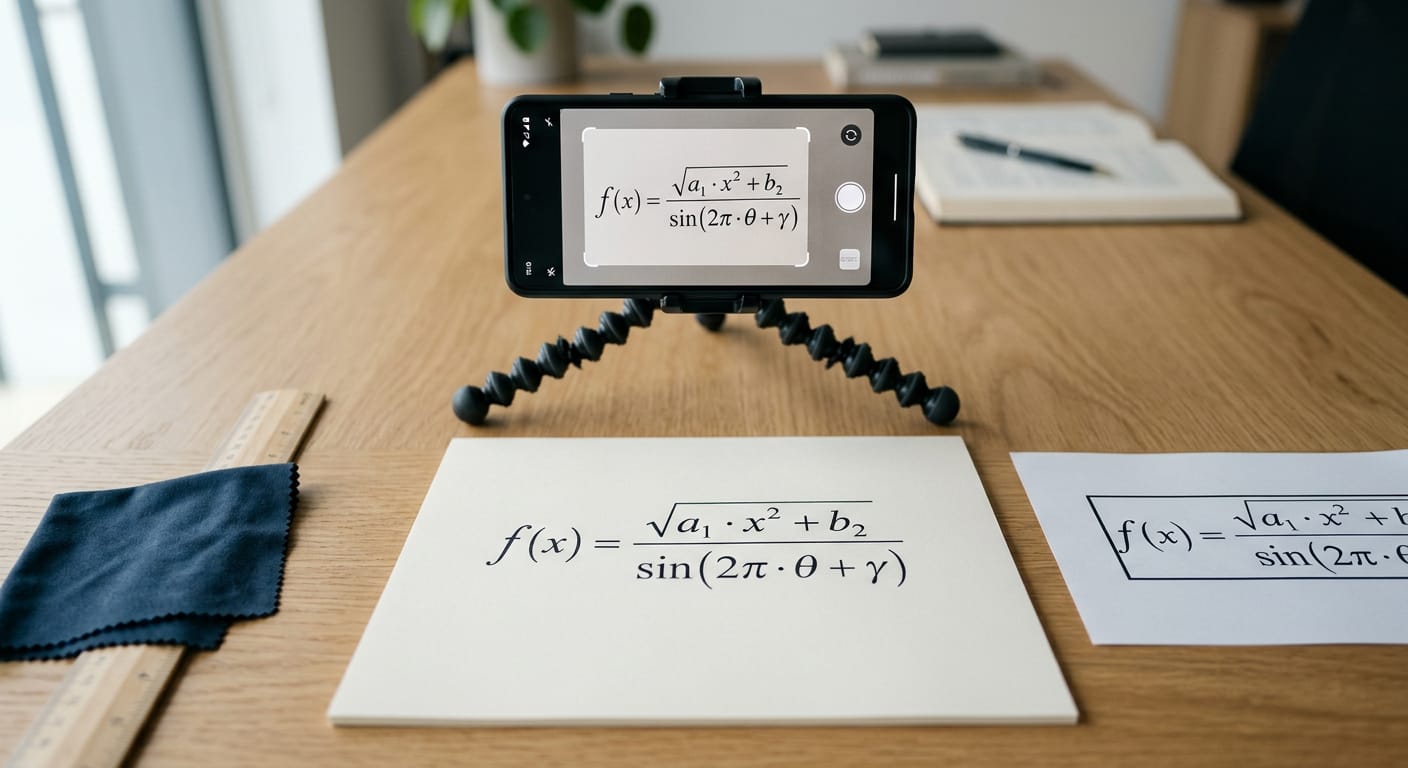
- Держите камеру строго параллельно листу или экрану — снимок сверху вниз, а не под углом, снижает перспективные искажения, которые особенно опасны для индексов и надстрочных символов.
- Используйте рассеянный естественный свет — у окна в пасмурный день или при дневном освещении без прямых солнечных лучей; жёсткая тень от руки или лампы через формулу воспринимается алгоритмом как дополнительный, несуществующий штрих.
- Отключите вспышку: она создаёт блики на глянцевой бумаге учебника и «выжигает» тонкие линии дробной черты или знака корня.
- Дайте камере сфокусироваться именно на тексте формулы, а не на фоне — большинство современных смартфонов позволяют тапнуть по нужной области перед съёмкой.
- Заполните кадр формулой почти полностью, оставив небольшие поля, но не срезая её края.
Отдельная рекомендация касается непосредственно математической записи, а не текста в целом: если вы фотографируете формулу с доски или страницы книги, старайтесь захватывать её целиком за один кадр, не разбивая на части — иначе распознающая модель потеряет связь между, например, знаком суммы и её верхним пределом, оказавшимся на границе снимка.
Разработчики специализированных сервисов распознавания формул отдельно рекомендуют использовать однотонный светлый фон и умеренную дистанцию съёмки: слишком близкий кадр обрезает контекст формулы, а слишком дальний снижает эффективное разрешение символов даже при в целом хорошем качестве камеры.
Если снимок уже сделан и переснять его нет возможности, помогает программная предобработка перед отправкой в распознающий сервис:
- обрежьте (crop) изображение так, чтобы в кадре осталась только формула — посторонний текст и фон вокруг сбивают детектор формул с толку;
- по возможности выровняйте наклон вручную в любом графическом редакторе, а не полагайтесь на автоматическую коррекцию;
- слегка увеличьте контраст, если формула написана бледным карандашом или маркером на светлой доске;
- сохраняйте файл в формате PNG или без значительного сжатия JPEG — артефакты компрессии разрушают именно тонкие линии, из которых состоят математические символы.
- Кадрирование (crop)
- обрезка изображения до области, содержащей только нужный объект — в данном случае формулу, — что уменьшает количество «постороннего» визуального шума, который должна обработать модель.
Наконец, полезная практическая привычка — при работе со сложными многострочными выкладками или системой уравнений разбивать съёмку на отдельные кадры для каждой формулы, а не пытаться захватить весь абзац целиком. Это не только повышает эффективное разрешение каждого отдельного выражения, но и облегчает работу детектора, которому не приходится сначала находить границы формулы среди окружающего текста.
Что делать, если формула снята с экрана монитора
Фотографирование с экрана добавляет специфическую проблему — муаровый эффект от наложения пиксельной сетки дисплея на матрицу камеры, из-за которого тонкие линии символов «дробятся» на паразитные узоры. Если есть возможность, лучше сделать программный скриншот вместо фотографирования экрана камерой: это полностью убирает муар и сохраняет исходное разрешение отображаемого изображения без потерь от повторной пересъёмки.
Формула требует не чтения, а понимания структуры
Распознавание математической записи сложнее обычного OCR потому, что формула является не линейной строкой, а пространственной конструкцией, где смысл зависит от вложенности, положения и масштаба каждого элемента. Классические системы, рассчитанные на последовательное чтение текста, теряют эту логику, тогда как специализированные нейросети вроде UniMERNet, Pix2Text, Mathpix и PaddleOCR восстанавливают её в виде структурированного LaTeX или MathML. Однако даже современная модель не застрахована от визуально похожих символов, рукописных особенностей и дефектов снимка, поэтому качество исходного изображения и проверка результата остаются частью самого процесса распознавания. На практике лучший результат даёт сочетание подходящего инструмента, аккуратно подготовленной фотографии и обязательного визуального контроля отрендеренной формулы.
