Разработчик Хади Джавед из компании RevelAI описал в мае 2026 года, как собрал и открыл Byaan — «маленького ИИ-аналитика, который работает рядом с вашей базой и отвечает на длинный хвост вопросов вида “можешь быстро вытащить вот это?”» (пост в блоге). Причина прозаичная: команда customer success постоянно дёргала инженеров с разовыми запросами, а дашборды такие вопросы не закрывают. Дальше он называет грабли, знакомые любому аналитику: «Модель редко была узким местом. Узким местом была обвязка вокруг модели». Разбираю, что из этого применимо к рабочему процессу аналитика с кодинг-агентом.
Почему «подключить ИИ к базе» не работает
Джавед разбирает два популярных подхода и объясняет, почему оба разваливаются. Готовые cloud-аналитики (Julius, Hex и подобные): для компании на 20-50 человек они «слишком тяжёлые» и требуют отдать третьей стороне широкий доступ к продакшену. Второй вариант — «направить Claude Code на базу»: безопасность («просить агента “пожалуйста, не делай DROP TABLE” — это не настоящий слой защиты») плюс прозрачность (CLI годится инженеру, но не сотруднику поддержки).
Его вывод перекликается с разбором на vc.ru: «ИИ знает о структуре ваших таблиц, но это не помогает автоматизировать вашу аналитику». Автор делит знание о данных на три уровня — структура, lineage и бизнес-семантика. Большинство ассистентов застревают на первом: information_schema даёт синтаксис, но не отвечает, почему amount считается без НДС, а total_amount с НДС.
Поэтому в основе Byaan лежит память: агент «учит вашу схему, ваши джойны, определения метрик и ошибки, которые он сделал вчера». Это и есть harness — обвязка, а не модель.
Цепочка анализа с агентом
Практический процесс для аналитика состоит из семи шагов. Это не про «топ нейросетей для данных», а про порядок работы: постановка вопроса, разведка, расчёт, визуализация, проверка, отчёт, воспроизводимость.
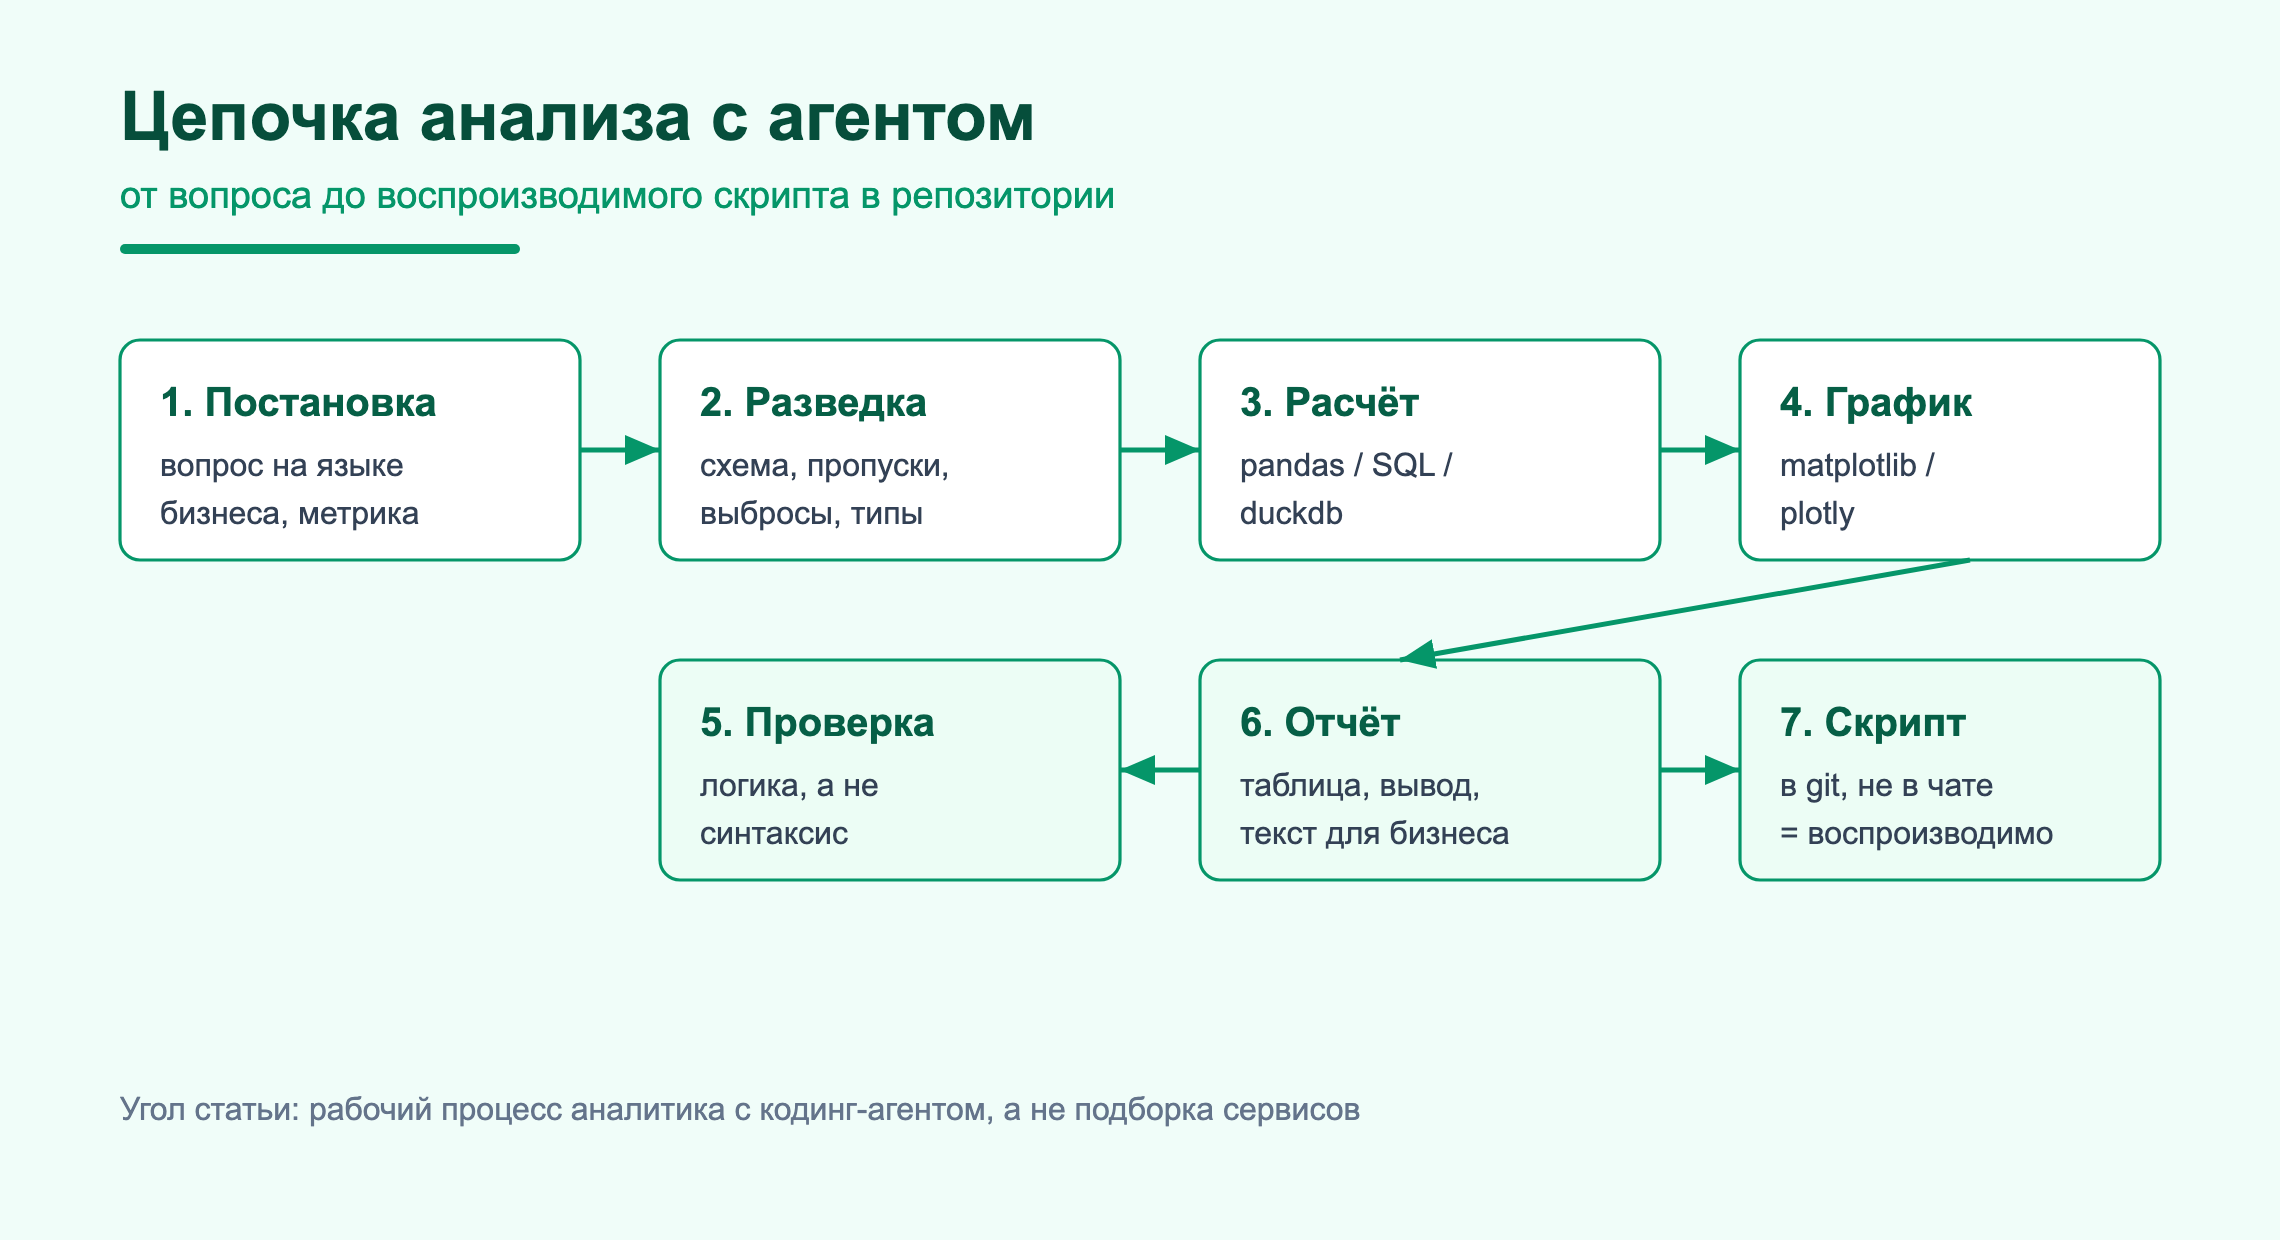
Центральный принцип — скрипт живёт в git, а не в чате. Расчёт, сделанный прямо в переписке с агентом, нельзя перезапустить через месяц и нельзя отревьюить. Тот же расчёт файлом в репозитории воспроизводим и прогоняется заново на свежих данных.
Таблица: задача / как ставим агенту / как проверяем
| Задача | Как ставим агенту | Как проверяем результат |
|---|---|---|
| Разведка CSV | «Покажи схему, типы, пропуски, выбросы» | df.info(), df.describe(), ручная сверка числа строк |
| Расчёт метрики | «Посчитай retention по когортам за квартал» | пересчёт вторым способом (pandas против SQL) |
| Сложный SQL | «Напиши запрос на duckdb по этой схеме» | EXPLAIN, сверка с промежуточной выгрузкой |
| Визуализация | «Построй график выручки по месяцам» | глазами: масштаб, подписи, единицы |
| Поиск аномалий | «Найди аномалии в этой колонке» | подтверждение конкретных выбросов вручную |
| Отчёт | «Собери выводы в markdown с цифрами» | каждая цифра сверена с расчётом |
| Воспроизводимость | «Оформи как скрипт в scripts/» | запуск с чистого окружения |
Смотрите на колонку проверки. Агент почти никогда не ошибается в синтаксисе — pandas-код запускается с первого раза. Он ошибается в логике: берёт не ту колонку, неверно понимает определение метрики, делает поспешную корреляцию. Поэтому проверка смещена в сторону смысла, а не компиляции.
Пример: разведка CSV и первые графики
Покажу рабочий цикл на промпте, который даёт агенту узкую задачу вместо расплывчатого «проанализируй данные»:
Ты — аналитик данных. У тебя файл sales.csv с колонками:
date, region, product, revenue, units.
1. Покажи схему: типы колонок, число строк, пропуски по колонкам.
2. Выведи выбросы в revenue методом IQR, не удаляй их — только перечисли.
3. Построй график суммарной выручки по месяцам (matplotlib, сохрани в fig-revenue.png).
4. В выводе к графику укажи, есть ли месяцы с неполными данными,
   прежде чем делать заключение о тренде.
Не переходи к следующему шагу, пока не покажешь результат предыдущего.
Ключевые требования — «не удаляй, только перечисли» и «проверь полноту данных перед выводом о тренде». Первое защищает от молчаливой потери выбросов, второе — от ошибки, когда неполный последний месяц принимают за падение. Инструменты обычные: pandas для таблиц, duckdb для SQL поверх CSV без сервера, matplotlib или plotly для графиков, Jupyter для разведки.
Нюанс приватности: Джавед описывает, что Byaan отдаёт только результаты запросов и контекст схемы, а соединение с базой остаётся на вашей инфраструктуре. В связке «локальный агент + CSV в репозитории» вы контролируете это полностью: файл читается с диска, наружу уходит только то, что вы сами отправите.
Где агент врёт
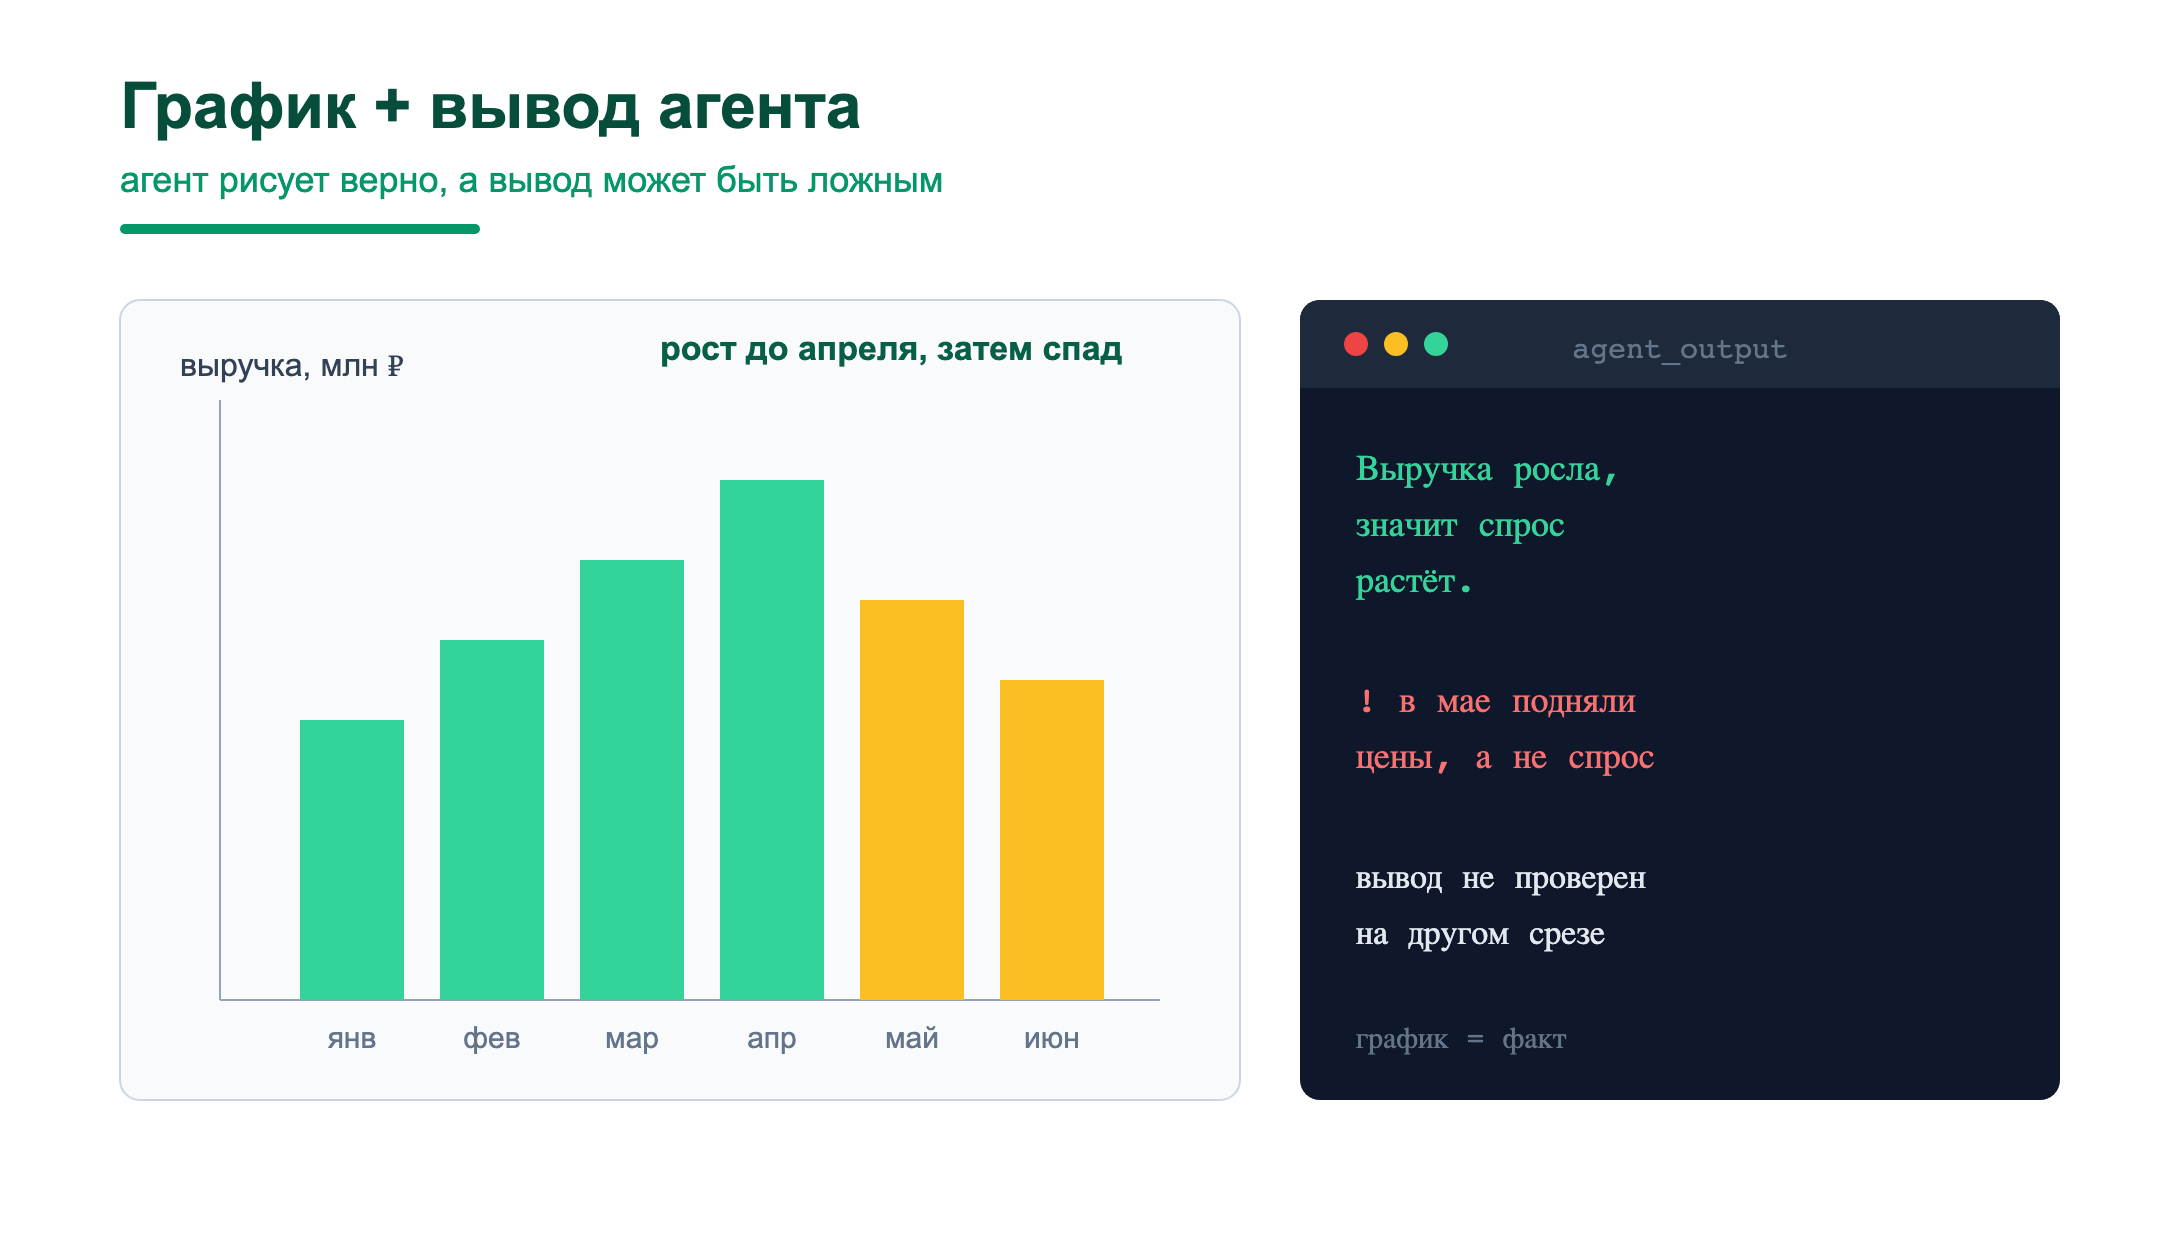
Самая опасная ошибка агента в аналитике — не падение скрипта, а уверенный неверный вывод по верно посчитанному графику. Показательный сюжет: агент видит рост выручки до апреля и спад к июню и пишет «спрос упал». А на деле в мае подняли цены, и спад — следствие ценового решения, а не спроса. Данные на графике верные, вывод — ложный.
Русскоязычный практик на vc.ru описывает ту же проблему со стороны бизнеса: «цифры всегда перепроверяю, иногда выдумывает уверенным тоном» (пост про 7 направлений, отданных ИИ). Что делать технически:
- Корреляция — не причина. Запретите агенту писать «X влияет на Y» без подтверждения. «X и Y меняются вместе» безопаснее.
- Считайте одну метрику двумя способами. Если retention из pandas совпал с retention из SQL — доверия больше.
- Проверяйте полноту данных перед трендом. Неполный период — частая причина ложного «падения».
- Держите единицы явными. Агент легко складывает рубли с тысячами рублей, если в колонках нет суффикса.
Воспроизводимость и ревью
Логичное продолжение — превратить разовую разведку в проверяемый артефакт. Практика Джаведа ровно про это: «корректировка становится частью системы». В терминах репозитория:
# структура, к которой стоит стремиться
analysis/
  scripts/
    load.py         # чтение и типизация
    metrics.py      # определения метрик (retention, ARPU)
    plots.py        # графики с фиксированными осями
  reports/
    q3-growth.md    # отчёт со ссылками на скрипты
  tests/
    test_metrics.py # проверка на эталонных данных
Почему это важно именно с агентом. Агент пишет код быстро, но не помнит прошлые сессии: без файлов он каждую неделю заново гадает, что значит «активный клиент». Когда определение метрики лежит в metrics.py, а разбор ошибок — в тестах, поведение агента стабильно. Это тот же принцип, что и тесты с pytest: сначала зафиксируйте ожидаемое, потом просите агента его достичь. Как это выглядит у больших команд — видно по каталогу GetCassis/analytics-agent-articles с разборами от data-команд: общая линия у всех — сначала контекст и метрики, потом агент.
Российские реалии
Чем это делать без зарубежных подписок. Ключевое преимущество аналитической задачи в том, что она не требует топовых моделей: pandas, duckdb, matplotlib и Jupyter — свободные и бесплатные, ставятся из pip или репозиториев дистрибутива. Кодинг-агент можно взять open-source (Cline, ZooCode в VS Code, Aider в терминале) и подключить к локальной модели через Ollama или LM Studio — код и данные не покидают машину, платить за токены не нужно.
Железо. Для локальной модели на 7-14 млрд параметров достаточно 16-32 ГБ оперативной памяти; ускорение на GPU заметно, но для разового анализа CSV хватает и процессора.
Оплата облачных агентов. Если всё же нужен облачный сервис (Julius, Hex, десктопные продукты), российские Visa и Mastercard не пройдут — процессинг отключён. Рабочие схемы — зарубежные карты, виртуальные карты с иностранным BIN, посредники; все они добавляют комиссию и риск для аккаунта.
Персональные данные. Аналитика часто касается клиентов, то есть персональных данных. У 152-ФЗ есть требования к обработке и хранению ПДн на территории РФ; это важно, когда вы отправляете выгрузки в зарубежную модель. Юридических выводов не делаю — это тема для юриста. Практическое правило: персональные данные в облако не отправлять.
Русскоязычный опыт. Материалов ровно по формуле «LLM + pandas + графики» в рунете мало, но есть практические кейсы:
- «Можно ли собрать BI-дашборды за 4 часа, если ты не аналитик? Эксперимент с MCP, PostgreSQL и Modus BI» — разработчик без опыта в аналитике через Claude Code и MCP прошёл путь от гипотез до дашбордов на реальных данных ГИБДД Санкт-Петербурга;
- «ИИ знает о структуре ваших таблиц, но это не помогает автоматизировать вашу аналитику» — почему SQL-агенту нужна карта данных и lineage, а не только схема;
- «Как оценивать ИИ-агентов в проде» — как построить проверяемые замеры для аналитического агента.
Честные ограничения
- Byaan — продукт автора, а не независимый бенчмарк. Джавед описывает свой опыт и свой инструмент; цифр вроде «сэкономили X часов» он не приводит, только качественную картину (customer success перестали дёргать инженеров). Это мнение практика, а не измеренный результат.
- Я не запускал Byaan. Описание того, как он устроен (read-only wrapper, память, MCP-сервер), взято из поста и README репозитория; проверки на своей базе не было.
- Агент ошибается в логике. Это не редкий сбой, а системная особенность: синтаксис pandas почти всегда верный, а определение метрики агент угадывает.
- Бизнес-семантика не выводится из схемы. Что такое «активный клиент», «выручка без НДС», какие статусы исключать — этого нет в
information_schema. Агенту это нужно явно положить. - График и вывод — разные вещи. Визуализация может быть идеальной, а интерпретация ложной. Проверять нужно интерпретацию, а не картинку.
- Локальные модели слабее на сложном. Для разведки CSV и простых графиков их хватает, но на многошаговых расчётах с бизнес-логикой они ошибаются чаще облачных. Компромисс между приватностью и качеством.
Вывод
ИИ для аналитики данных — это не «подключить нейросеть к базе и она всё посчитает». Как показал кейс Byaan, узкое место — обвязка: определения метрик, память о прошлых ошибках и слой ограничений, который не даёт агенту испортить данные.
Практический порядок: опишите метрики и бизнес-правила текстом в репозитории, заведите скрипты с фиксированными определениями, и только затем просите агента считать и рисовать. Каждый вывод проверяйте вторым способом, а удачный расчёт сохраняйте скриптом, а не ответом в чате. Тогда аналитика с агентом становится воспроизводимой.
Связанные статьи
- ИИ для обработки данных — парсинг и подготовка данных агентами
- ИИ для баз данных и SQL — генерация SQL-запросов
- ИИ-тесты с pytest и Playwright — как проверять код агента тестами
- ИИ для программистов — базовый разбор, с чего начать
Читайте также: ИИ-агенты: примеры того, что агент реально делает в 2026 · Локальный или облачный кодинг-агент: где запускать в 2026
