Спросите Яндекс «ии агенты примеры» и получите десяток статей вида «15 AI-агентов для роста бизнеса». Ни один пример там нельзя проверить: агент «оптимизирует процессы» и «повышает эффективность». В разработке всё иначе: есть дифф, есть зелёный или красный прогон, есть ревьюер, который либо подписал, либо нет. Ниже — восемь сценариев из реальной практики 2026 года, каждый с источником, разметкой «агент / человек» и честным местом, где агент ломается.
Задача → результат → проверка
Общий каркас, по которому разобраны все примеры: задача, способ постановки агенту, что получается на выходе, как это проверить и где ломается. Если хотя бы один пункт не заполняется, сценарий не для агента.
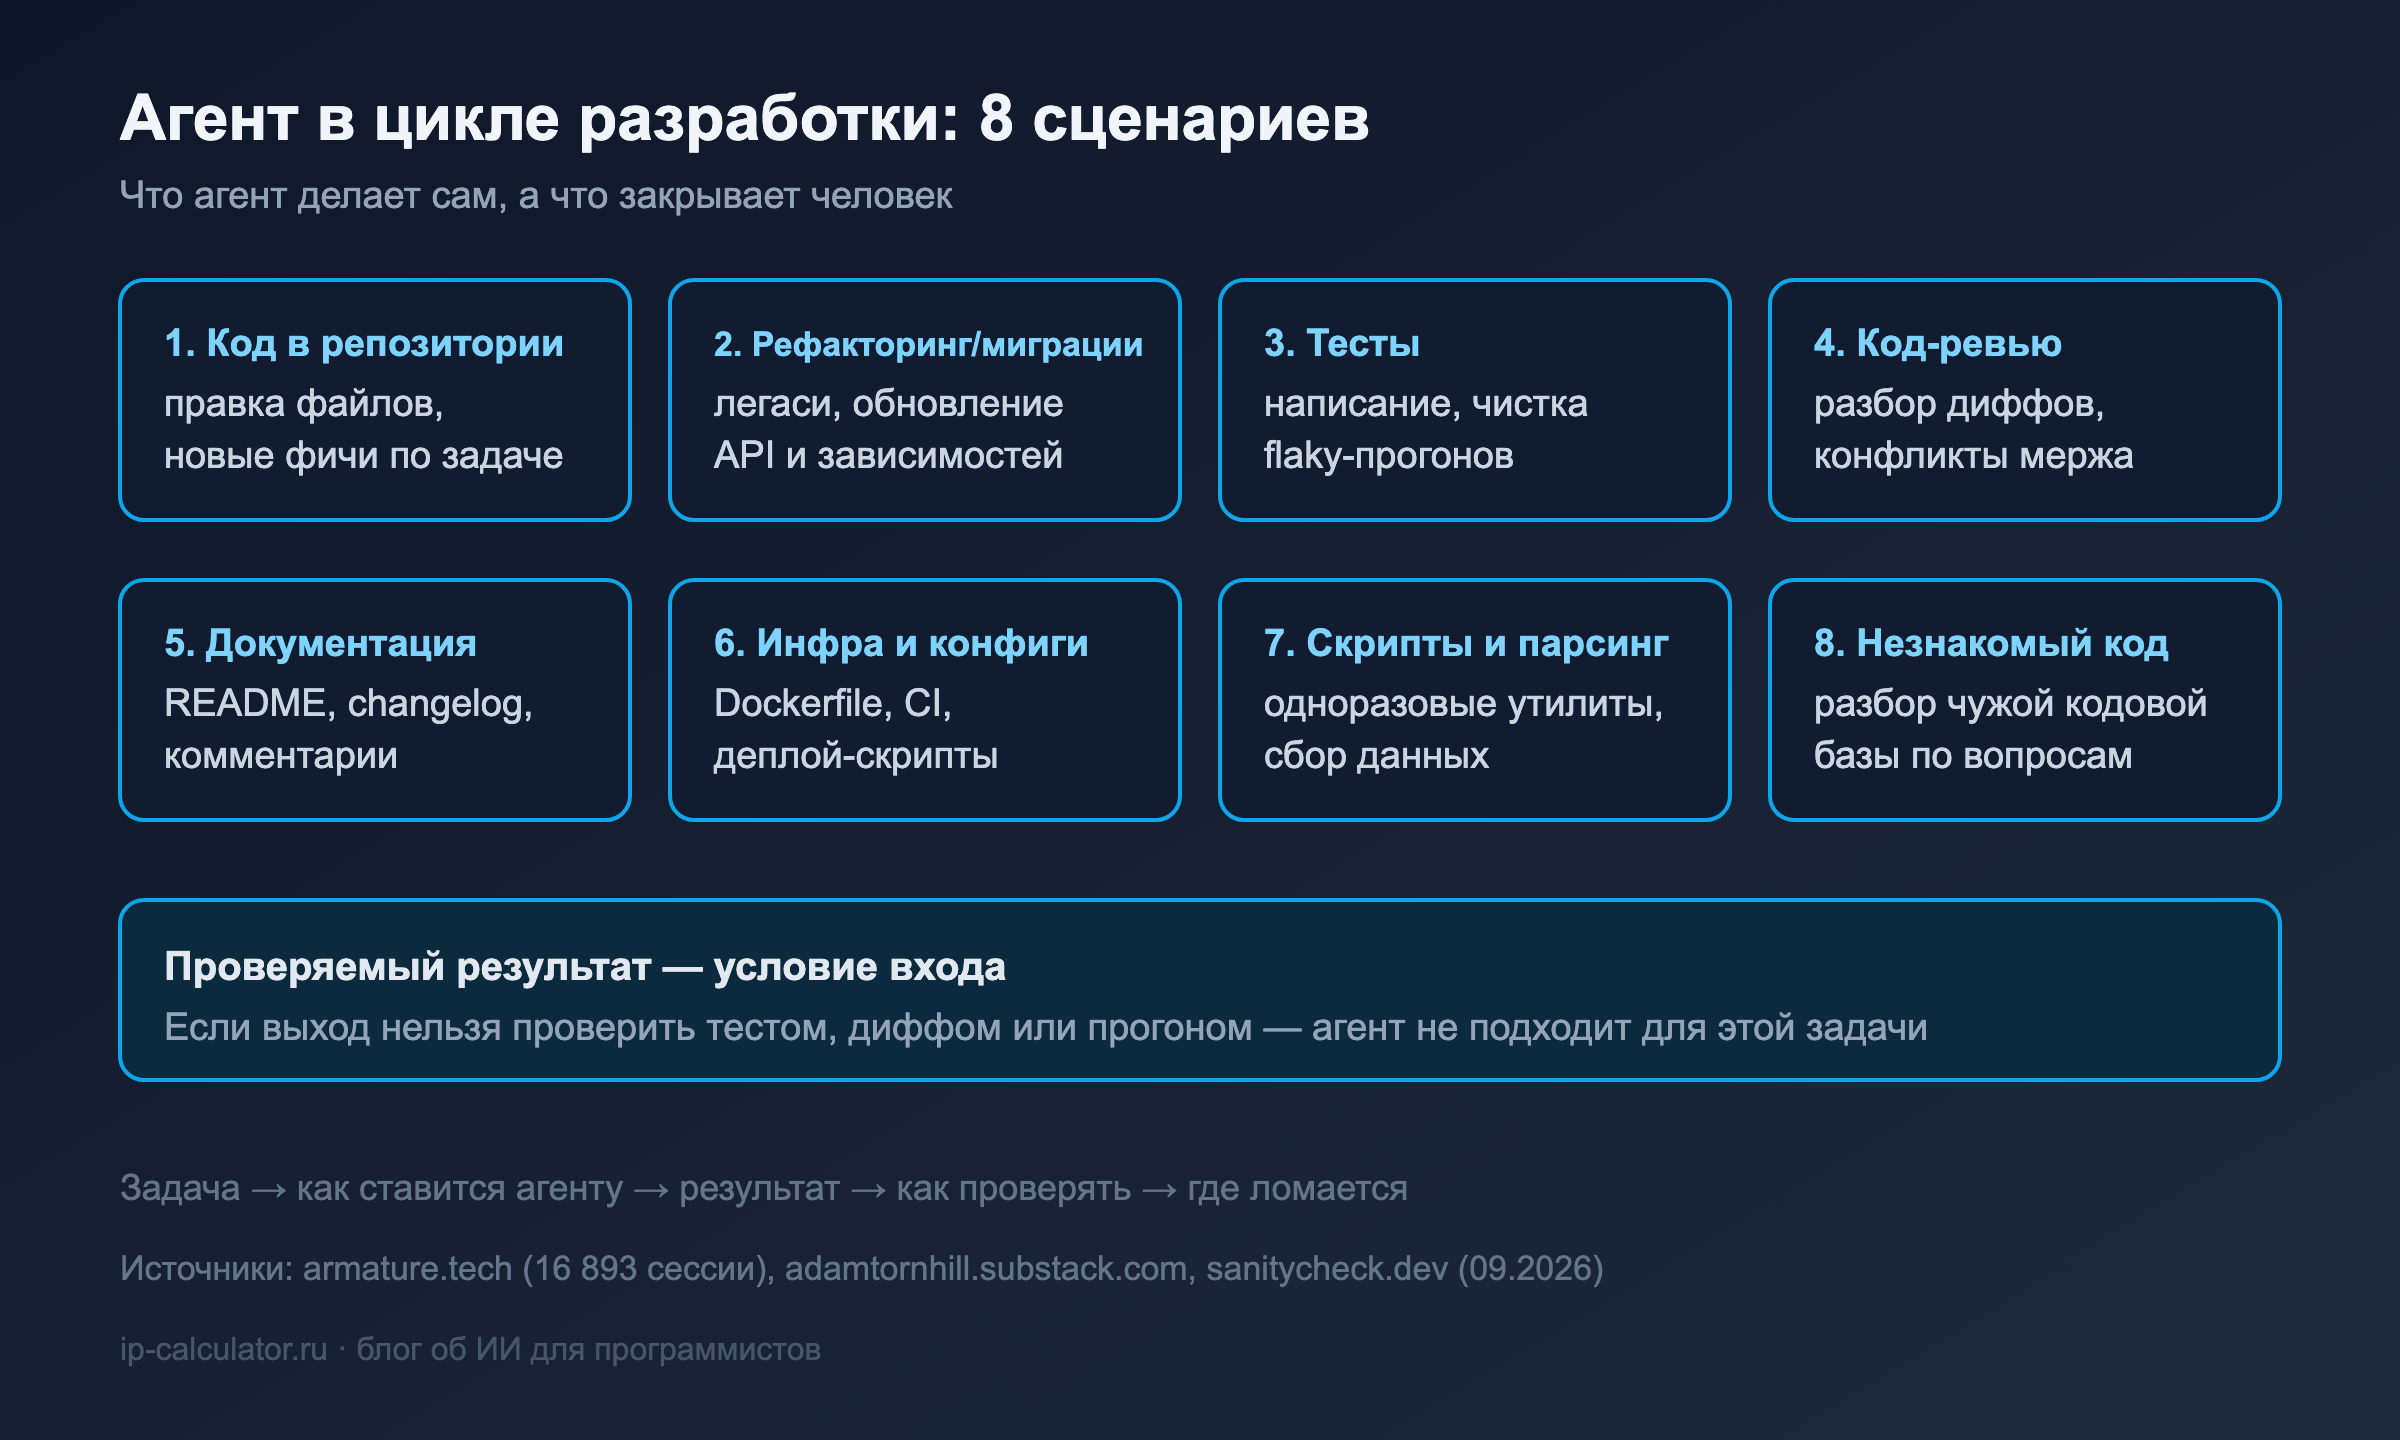
| Задача | Что делает агент | Кто и как проверяет |
|---|---|---|
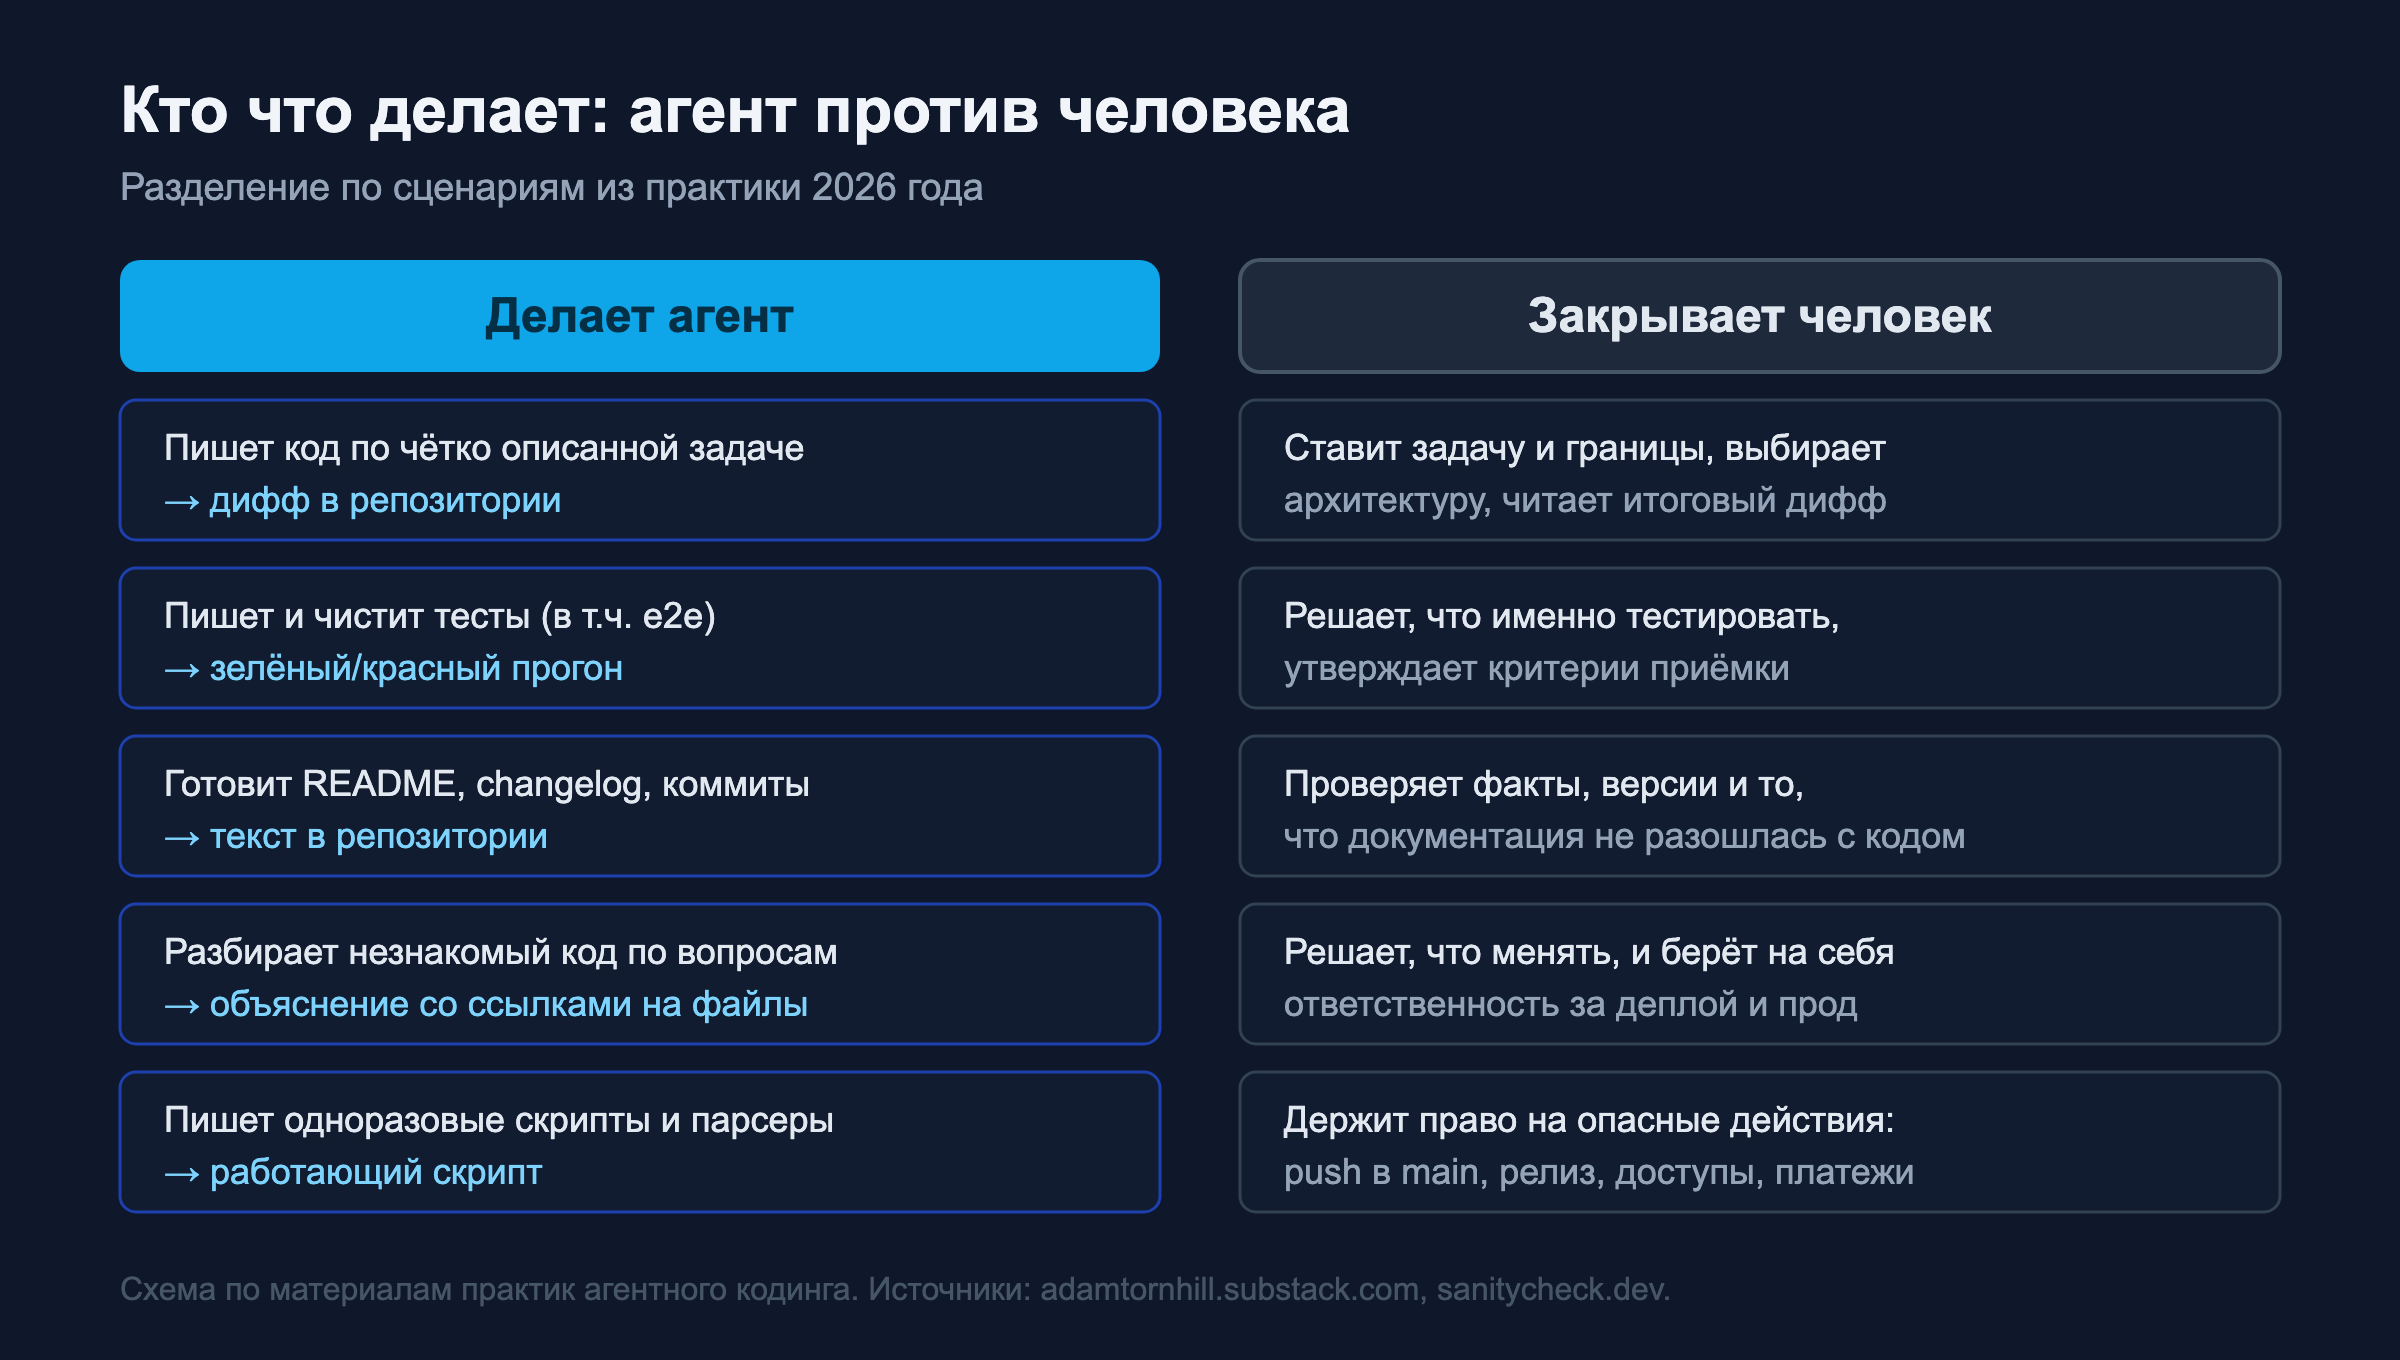
| Код в репозитории | правит файлы, делает фичи по описанию | человек читает дифф |
| Миграции/рефакторинг легаси | меняет модуль, обновляет API | существующие + новые тесты |
| Тесты | пишет и чистит unit/e2e | прогон зелёный/красный |
| Код-ревью | разбирает диффы, конфликты мержа | второй агент или человек |
| Документация | README, changelog, коммиты | сверка с кодом и версиями |
| Инфра и конфиги | Dockerfile, CI, скрипты деплоя | ручной прогон на стенде |
| Скрипты и парсинг | одноразовые утилиты, сбор данных | сравнение с эталоном |
| Незнакомый код | объясняет чужую кодовую базу | человек перепроверяет выводы |
1. Генерация и правка кода в существующем репозитории
Задача: добавить функцию в уже живущий проект, не сломав окружение. Способ постановки: прямое описание симптома и желаемого состояния. Armature на 16 893 сессиях показал, насколько результат зависит от контекста: с одинаковым запросом «подключи отправку инвойсов на email» на четырёх репозиториях в четырёх языках агенты выдали четырёх разных победителей — Resend на TypeScript, Sendgrid на Python, Postmark на Go, Azure ACS на Java.
Проверка: дифф репозитория. Ломается на выборе библиотеки под ваш реальный стек — агент охотно подставляет популярный по вебу вариант, который не сочетается с вашими зависимостями.
2. Миграции и рефакторинг легаси
Adam Tornhill, автор CodeScene, после 25 лет Test-Driven Development отказался от TDD ради агентного кодинга. Его объяснение важнее любого туториала: «The agentic feedback loop is larger and (much) less granular» — цикл обратной связи у агента крупнее и заметно менее гранулярный. Один проход агента заменяет десятки мелких циклов «красный-зелёный-рефакторинг», на которых строится TDD.
Что это значит на практике: рефакторинг агент делает крупными шагами, а человек отвечает за границы. Tornhill оставил от TDD принцип двойной записи — любую правку он ведёт через падающий тест, потому что агент любит либо удалить неудобный тест, либо подогнать условие под ошибочный код.
3. Тесты: написание и чистка
Задача: покрыть существующий код тестами или вычистить flaky-прогоны. Способ постановки у Tornhill обратный привычному: сначала end-to-end тесты, потом код. «With the e2e tests nailed down, I typically let the agent proceed and write the code that makes them pass» — когда e2e-тесты зафиксированы, он позволяет агенту писать код, который их проходит.
Ломается там же, где и TDD: если тест проверяет не то, агент бодро «пройдёт» его и закрепит баг. Для UI-прогонов появились отдельные сервисы вроде SanityCheck (агент описывается фразой «добавь в корзину и проверь счётчик», без селекторов), но и там правила «что агенту нельзя» задаёт человек.
4. Код-ревью и разбор конфликтов
Задача: смотреть не свой код, а чужой дифф, и ловить конфликты мержа. Приём, который стал нормой в 2026-м: ревьюера запускают не той же моделью, что писала код. В проекте neal (planner, coder и reviewer, каждый на своём провайдере) это ключевое решение описано прямо: «The coder and reviewer run on different vendors. The review is genuinely adversarial» — код и ревью идут на разных вендорах, потому что второе мнение проверяет первое, вместо того чтобы модель оценивала саму себя.
Проверка: reviewer в neal физически read-only — объявлен на уровне провайдера и закреплён механически (песочница ОС для Codex, allow-list инструментов для Claude). Ломается на контексте: ревью без истории репозитория пропускает нарушения архитектурных границ, поэтому часть задач всё равно уходит человеку.
5. Документация и changelog
Задача: README, комментарии, changelog к релизу. Здесь честный результат агента — текст в репозитории, а проверка — сверка с кодом и версиями. Ломается на фактах: агент уверенно описывает версии и флаги, которых не было, поэтому раздел «на момент публикации» здесь не формальность, а обязательное правило.
6. Инфраструктура и конфиги
Задача: Dockerfile, CI-пайплайн, скрипты деплоя, конфиги окружений. Официальный пример 2026 года — доступ внешних агентов к Xcode в документации Apple: агент гоняет сборки и тесты через штатные инструменты, а не наугад. Из сообщества — oto-dock, self-hosted «company OS», где агенты Claude Code и Codex разведены по отделам; на момент сбора материалов это был заметный проект в треде Hacker News.
Проверка: прогон на реальном стенде. Ломается на секретах и правах: конфиг без изоляции даёт агенту доступ к тому, к чему он не должен прикасаться, — поэтому write-пути и секреты задают заранее, а не «по ходу».
7. Скрипты и парсинг
Задача: одноразовые утилиты, разбор логов, сбор данных. Это самый безопасный сценарий: результат — работающий скрипт, проверка — сравнение вывода с эталоном. Ломается на данных, которых автор скрипта не видел: агент пишет парсер под пример из промпта и падает на первой нестандартной строке.
8. Разбор незнакомого кода
Задача: понять чужую кодовую базу и ответить на вопрос по ней. Способ постановки: вопрос вместо задачи. Armature показал, что стратегии тут у агентов расходятся: Codex почти всегда лезет в веб (94% сессий, в 9 случаях из 10 через оператор site:), а Claude Code опирается на свои знания и ищет в сети лишь в ~30% случаев. Это значит, что для незнакомого стека вывод агента надо перепроверять, а не принимать как факт.
Общий паттерн: как ставить задачу, чтобы получить проверяемый результат
Сценарии разные, постановка — одна. Работает такой шаблон:
Задача: <что нужно изменить, в каком модуле>
Контекст: <файлы и зависимости, которые агент должен прочитать>
Границы: <что НЕ трогать: пути, секреты, ветки>
Проверка: <команда теста / критерий приёмки, по которому я приму работу>
Формат вывода: <дифф | патч | список изменённых файлов>
Три правила поверх шаблона, выведенные из разобранных источников:
- Проверка — условие входа. Если выход нельзя проверить тестом, диффом или прогоном, задача не для агента.
- Правку ведите через падающий тест. Иначе агент выберет путь наименьшего сопротивления — удалит тест или подгонит условие под код.
- Ревьюера берите с другой моделью. Один вендор не должен проверять сам себя.
Чего агент не делает
По общему признанию авторов кейсов, из списка выпадает то, что нельзя свести к проверяемому диффу: выбор архитектуры, оценка продуктовых компромиссов, ответственность за деплой в прод, работа с юридическими и денежными действиями без ручного подтверждения, а также приёмка собственного результата. Tornhill формулирует это жёстче: «Code is no longer for my consumption» — код больше не для его чтения; человек проверяет через инструменты и тесты, а не построчно.
Честные ограничения
- Контекст важнее промпта. Один и тот же запрос на разных репозиториях даёт разных победителей (4 языка — 4 разных провайдера email). Качество результата зависит от того, что агент прочитал, а не от формулировки.
- Метрики раздуты. Armature прямо оговаривается, что продаёт услуги dev-инструментам, — выводы по «выбору инструментов» смотрите как наблюдение, а не как независимый замер. Tornhill пишет про свой опыт, а не про универсальное правило.
- Цифры не заменяют проверку. Часть проектов из примеров — свежие репозитории с десятками звёзд; на реальном объёме они могут вести себя иначе.
- Никакой из сценариев не снимает человека с приёмки. Даже в полностью автоматическом цикле человек задаёт критерий, по которому работу примут, — иначе проверять нечего.
Российские реалии
- Доступность инструментов. Claude Code, Codex и Cursor работают из РФ нестабильно: вход через аккаунт часто требует VPN, а оплата подписок российскими картами не проходит (Visa/Mastercard отключены от процессинга РФ). Рабочие схемы — посредники, виртуальные карты с иностранным BIN, иностранные карты. Open-source альтернативы (Cline, Aider, neal, oto-dock) ставятся из GitHub и npm без ограничений.
- Реальный опыт внедрения в команду. Разбор «как мы сделали Cursor-агента членом команды» — Habr, hooks и safe-list: главный вывод авторов в том, что «read» не значит «complies», и правила надо закреплять хуками, а не текстом в контексте. Опыт команды за год использования LLM (включая AI-код-ревью и тесты) — Habr.
- Что говорят про эффект. Cloud.ru о построении AI-first команды за полгода — про культуру и измеряемость, а разбор внедрения на 500 инженеров даёт трезвую цифру: рост использования ИИ не равен ускорению разработки.
Связанные статьи
- Что такое агентный кодинг — архитектура агентов до перехода к примерам
- AI-ассистент программиста: кейсы — практические сценарии использования ассистентов
- AI-тесты: pytest и Playwright — как агент пишет тесты на конкретном стеке
- AI-рефакторинг легаси-кода — разбор сценария №2 подробнее
- ИИ для git — коммиты, ветки и разбор истории агентом
- Мультиагентный workflow: координация — как связать роли planner/coder/reviewer
Читайте также: Вайб-кодинг: что это и как работать с ИИ-агентом на ощущениях · ИИ для разработки сайтов: фронт, бэк и деплой с агентами
